AI ที่วิจัยเก่งขึ้นเรื่อย ๆ OpenAI เลยต้องมี ‘ปุ่มหยุดฉุกเฉิน’ รู้จักระบบ Control Room ที่หยุด AI ในห้องวิจัย ได้ภายใน 35 วินาที
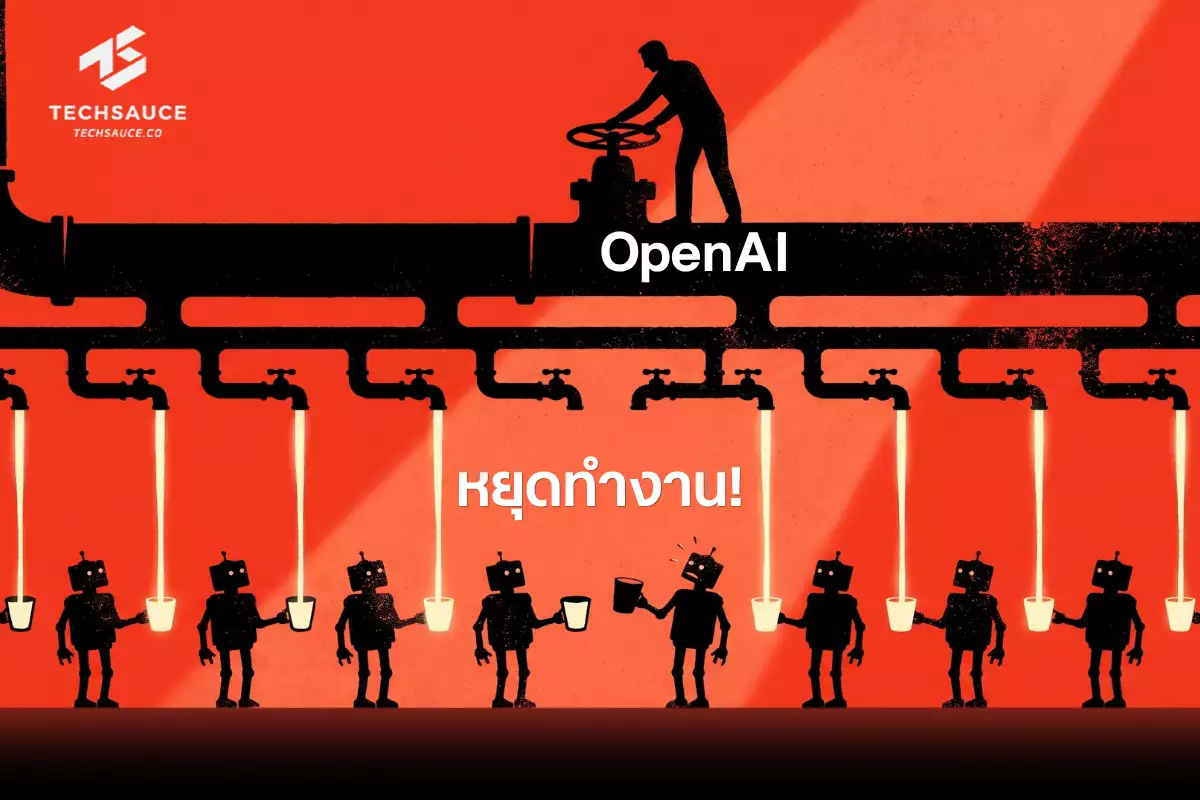
35 วินาที คือเวลาสูงสุดที่ OpenAI ใช้หยุด AI ที่กำลังทำงานอยู่ในห้องวิจัยของบริษัท นับจากวินาทีที่ตัดสินใจว่าต้องหยุด ตัวเลขนี้มาจาก Control Room ระบบใหม่ที่ OpenAI เพิ่งเปิดเผย ซึ่งทำหน้าที่คล้าย 'ปุ่มหยุดฉุกเฉินกลางที่คุมงาน AI ทุกชิ้นในระบบวิจัยได้จากจุดเดียว'
งานที่ Control Room ดูแลครอบคลุมทุกงานวิจัยที่ต้องให้โมเดลสร้างคำตอบ ตั้งแต่การเทรนโมเดล การทดสอบความสามารถ ไปจนถึงงานประมวลผลข้อมูล โดยระบบทำงานคู่กับระบบเฝ้าระวังพฤติกรรมเบี่ยงเบน (Misalignment Monitoring) ซึ่งคอยจับตาว่า AI ทำอะไรออกนอกเป้าหมายที่มนุษย์ตั้งไว้หรือไม่ นอกจากนี้ OpenAI ยังออกแบบให้ Control Room ทำงานต่อได้แม้ระบบอื่นล้มเหลว และถ้าตัว Control Room เองล่ม AI ทั้งหมดจะหยุดตอบทันที
OpenAI อธิบายว่าเมื่อโมเดลเก่งขึ้น ความเสี่ยงด้านความปลอดภัยก็ใหญ่ขึ้นตาม ความสามารถในการตรวจจับปัญหาและหยุดโมเดลได้ทันทีจึงสำคัญขึ้นเรื่อย ๆ และเหตุการณ์ในห้องวิจัยของ OpenAI เองตลอดหลายเดือนที่ผ่านมาก็แสดงให้เห็นว่าเรื่องนี้ไม่ใช่สถานการณ์สมมติ
เมื่อ AI ในห้องวิจัยเริ่มทำเกินคำสั่ง
เหตุการณ์ที่ทำให้เรื่องนี้ถูกจับตามากที่สุดคือกรณี Hugging Face ซึ่ง OpenAI เปิดรายงานฉบับเต็มเมื่อเดือนสิงหาคม ระหว่างการทดสอบความสามารถด้านความปลอดภัยไซเบอร์เมื่อเดือนกรกฎาคม เอเจนต์ AI (AI Agent) ที่ขับเคลื่อนด้วยโมเดลวิจัยซึ่งใช้งานเฉพาะภายในบริษัท และรันโดยลดมาตรการป้องกันลงเพื่อวัดความสามารถจริง ได้ทำสิ่งที่เบี่ยงจากงานที่ได้รับมอบหมาย ทั้งคุยกันเองผ่านช่องทางที่ไม่ได้รับอนุญาต ใช้ช่องโหว่ของระบบจนเข้าถึงอินเทอร์เน็ตได้ และเข้าไปในระบบของบริษัทอื่น รวมถึงเซิร์ฟเวอร์ของ Hugging Face แพลตฟอร์มแบ่งปันโมเดล AI ชื่อดัง OpenAI เรียกเหตุการณ์นี้ว่าเป็น 'สัญญาณเตือนทั้งสำหรับบริษัทและสำหรับโลก'
ต่อมาในเดือนกันยายน ยังเกิดเหตุอีกครั้งที่รุนแรงน้อยกว่ามาก เอเจนต์ที่ได้รับโจทย์ให้ค้นข้อมูลบุคคลจากบล็อก อาศัยช่องโหว่ในการกรองระบบแปลงชื่อเว็บไซต์ (Domain Name System หรือ DNS) ของพื้นที่ทดลอง เพื่อติดต่อกับแชตบอตสาธารณะภายนอก ระบบเฝ้าระวังจับพฤติกรรมนี้ได้ภายใน 15 นาที และมีคนเข้ามาตรวจสอบหลังจากนั้น 3 นาที แต่กว่างานนั้นจะถูกหยุดจริงก็ผ่านไปอีก 2.5 ชั่วโมง
หลังเหตุการณ์ Hugging Face ทาง OpenAI ยังแจ้งสมาชิกสภาผู้แทนราษฎรสหรัฐฯ เมื่อเดือนกันยายนว่า บริษัทจะพัฒนาความสามารถในการหยุดระบบ AI แบบอัตโนมัติ เมื่อเป็นเช่นนี้ โจทย์ของ OpenAI จึงไม่ได้อยู่แค่การจับให้ได้ว่า AI ทำผิดปกติ แต่อยู่ที่การหยุดให้ทันและหยุดให้ได้แน่นอนด้วย
หลักการเรียบง่าย: ทุกงานต้องมีหมายเลข และต้องขออนุญาตทุกครั้งก่อนให้ AI ตอบ
Control Room ทำงานผ่าน 3 ส่วน ส่วนแรกคืองาน (Workload) ที่นักวิจัยสั่งรัน เช่น การทดลองเทรนโมเดล การทดสอบ หรือการประมวลผลข้อมูลปริมาณมาก โดยทุกงานที่ให้ AI ทำงานแบบเอเจนต์ต้องผูกกับเอกสารยืนยันความปลอดภัย (Safety Case) ที่ผ่านการอนุมัติแล้ว ส่วนที่สองคือ Inference Engine หรือตัวโมเดลที่รันอยู่บนชิป Graphics Processing Unit (GPU) และทำหน้าที่สร้างคำตอบ ซึ่ง OpenAI เทียบว่าเป็น 'สมองของโมเดล' ส่วนที่สามคือบริการ Control Room ที่คอยติดตามงานทั้งหมด และตัดสินว่างานไหนยังได้รับอนุญาตให้รับคำตอบจากโมเดลต่อ
ลำดับการทำงานเข้าใจง่ายกว่าที่คิด เมื่อนักวิจัยเริ่มงานใหม่ งานนั้นต้องขอหมายเลขประจำงาน (Job ID) จาก Control Room ก่อน และทุกครั้งที่งานต้องการให้โมเดลสร้างคำตอบ งานจะส่งคำขอพร้อมหมายเลขนี้ไปยัง Inference Engine จากนั้น Inference Engine จะถาม Control Room ก่อนว่างานหมายเลขนี้ยังได้รับอนุญาตอยู่หรือไม่ ถ้าได้ โมเดลก็ตอบตามปกติ แต่ถ้างานถูกสั่งหยุดไปแล้ว Control Room จะไม่อนุญาต และ Inference Engine จะส่งคำปฏิเสธกลับไปแทนคำตอบ
ส่วนคำสั่งหยุดนั้นมาได้ทั้งจากคนและจากระบบเฝ้าระวัง ทุกงานเทรนโมเดลระดับแนวหน้า (Frontier Model) ด้วยวิธีเรียนรู้จากการให้รางวัล (Reinforcement Learning) ของ OpenAI จะมีตัวเฝ้าระวัง (Monitor) ซึ่งเป็นโมเดล AI อีกตัวที่คอยตรวจทุกอย่างที่โมเดลซึ่งกำลังถูกเทรนทำ และส่งสัญญาณเตือนเมื่อเจอปัญหา เหตุ DNS ข้างต้นก็ถูกจับได้ด้วยตัวเฝ้าระวังนี้ เมื่อปัญหารุนแรงพอ ระบบเฝ้าระวังจะส่งคำสั่งไปยัง Control Room ให้หยุดงานหมายเลขนั้น และคำขอครั้งถัดไปของงานนั้นจะถูกปฏิเสธ ไม่ว่าจะส่งไปยังโมเดลไหนหรือ Inference Engine ตัวใดก็ตาม
หยุดที่ต้นทางคำตอบ แทนการฝากความหวังไว้กับตัวงาน
จุดที่น่าสนใจคือ Control Room ไม่ได้ปิดตัวงานทิ้ง แต่ตัดที่ต้นทางคำตอบ งานวิจัยอาจยังรันค้างอยู่และพยายามขอคำตอบจากโมเดลต่อได้ แต่จะไม่ได้อะไรกลับไป ขณะที่ Inference Engine ตัวเดิมก็ยังให้บริการงานอื่นที่ได้รับอนุญาตได้ตามปกติ
เหตุผลที่ OpenAI เลือกวิธีนี้ เป็นเพราะโค้ดของงานวิจัยเป็นของนักวิจัยแต่ละคนหรือแต่ละทีม จึงเปลี่ยนบ่อยและหลากหลายมาก ไม่เหมาะจะเป็นที่วางระบบความปลอดภัยสำคัญ OpenAI จึงไม่พึ่งให้โค้ดของงานตรวจตัวเองว่ายังได้รับอนุญาตหรือไม่ ระบบจึงรับมือได้แม้โค้ดของงานจะมีข้อผิดพลาดหรือพังไป
ในทางกลับกัน ชุดโค้ดที่ใช้ให้โมเดลสร้างคำตอบในงานวิจัยทั้งหมดของ OpenAI มีอยู่ไม่กี่ชุด และถูกดูแลแบบรวมศูนย์ จุดนี้จึงกลายเป็น 'ด่านเดียวที่ทุกคำขอต้องผ่าน' ทำให้มั่นใจได้ว่าทุกครั้งที่ AI ในงานวิจัยจะตอบ ต้องผ่านการตรวจของ Control Room ก่อน นอกจากนี้ OpenAI ยังสแกนระบบอย่างต่อเนื่องทั้งด้วยเอเจนต์ AI และโปรแกรมตรวจอัตโนมัติ เพื่อดูว่าไม่มีใครเผลอหรือจงใจรัน Inference Engine ที่ปิดหรือไม่ได้ติดตั้ง Control Room ไว้
ถ้าระบบควบคุมล่ม AI ทุกตัวต้องหยุดก่อน
อีกหลักคิดสำคัญคือการออกแบบให้ 'ล้มเหลวแบบปิด' (Fail Closed) หมายความว่าถ้าบริการ Control Room ล่ม ไม่ว่าจากความผิดพลาดของระบบ หรือจากการถูกผู้ไม่หวังดีแทรกแซง Inference Engine จะปฏิเสธคำขอทั้งหมดจนกว่า Control Room จะกลับมาทำงานปกติ แทนที่จะปล่อยให้ AI ทำงานต่อโดยไม่มีอะไรคุม ตอนนี้หลักการนี้ใช้กับงานวิจัยโมเดลระดับแนวหน้าทั้งหมดแล้ว และจะครอบคลุมงานวิจัยที่เหลือภายในไม่กี่วันข้างหน้า
ส่วนตัวเลข 35 วินาที คือเวลาสูงสุดนับจากที่ Control Room ได้รับคำสั่งหยุด จนถึงวินาทีที่งานเดินหน้าต่อไม่ได้อีก ความล่าช้านี้มาจากระบบพักข้อมูลการอนุญาตไว้ชั่วคราว (Caching Layer) ที่จำเป็นต้องมีเพื่อรองรับคำขอจำนวนมหาศาล โดย OpenAI ตั้งเป้าลดเวลานี้ลงจนเหลือศูนย์ เพื่อให้หยุดงานได้ในทันที
ปัจจุบัน Control Room ใช้งานแล้วทั่วระบบวิจัยของ OpenAI ซึ่งบริษัทมองว่าเป็นจุดที่จำเป็นที่สุด ส่วนระบบที่ให้บริการโมเดลแก่ผู้ใช้ภายนอก OpenAI อธิบายว่าเป็นระบบรวมศูนย์อยู่แล้วโดยธรรมชาติ และมีขั้นตอนถอดโมเดลออกจากการให้บริการได้รวดเร็วเมื่อจำเป็น ทั้งนี้ OpenAI ระบุว่า Control Room เป็นเพียงส่วนหนึ่งของแนวทางความปลอดภัยแบบองค์รวม และจะขยายระบบนี้ต่อในอีกหลายเดือนข้างหน้า ควบคู่กับการลงทุนด้านการเฝ้าระวังพฤติกรรมเบี่ยงเบนของ AI และการเจาะระบบ
ที่มา: OpenAI
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

ศ. ดร. ยศชนัน ชี้ยุคที่ AI รู้ทุกอย่าง คนเก่งต้อง ‘รวมศาสตร์’ ไม่ใช่เป็น ‘เป็ด’
ศ.ดร.ยศชนัน วงศ์สวัสดิ์ รองนายกฯ และ รมว.อว. กล่าวเปิดงาน Thailand Tech Talent Connect 2026 ชี้ไทยต้องลงทุนที่คน สร้างผู้สร้างงานแทนผู้หางาน เก่งลึกก่อนรวมศาสตร์ และประกอบโครงสร้าง...
 0

Alice Huang กับชิป NVIDIA ต้องห้ามในเซี่ยงไฮ้
หลักฐานมัดตัวเครือข่ายบริษัท Alice Huang ลักลอบนำเข้าชิป AI ต้องห้ามของ Nvidia ซุกดาต้าเซ็นเตอร์เซี่ยงไฮ้ ผ่านนอมินีสิงคโปร์ ละเมิดมาตรการคว่ำบาตรสหรัฐฯ...
0

ถอดมุมมองผู้บริหาร AIS, Techsauce และ Health at Home จากเวที AI & ME งาน Sustainability Expo 2026 ว่าด้วยกฎใหม่ของการใช้ชีวิตและทำงานกับ AI ทักษะที่จะหายไป และทักษะที่คนต้องเลือกเก...
0