Google DeepMind เปิดตัว AlphaGenome 2 AI ที่อ่าน DNA ได้ลึกถึงระดับเซลล์
เซลล์กล้ามเนื้อหัวใจกับเซลล์ภูมิคุ้มกันในร่างกายเราถือ DNA ชุดเดียวกันทุกตัวอักษร แต่กลับทำงานคนละหน้าที่ เพราะแต่ละเซลล์เลือกเปิดและปิดยีนไม่เหมือนกัน คำถามว่าความต่างเล็ก ๆ ใน DNA ของแต่ละคนไปกระทบการเปิดปิดยีนในเซลล์ชนิดไหนบ้าง คือโจทย์ที่ Google DeepMind ตั้งใจตอบด้วย AlphaGenome 2 โมเดล AI รุ่นใหม่ที่เพิ่งเปิดตัว
AlphaGenome 2 ทำนายว่าลำดับ DNA และความแปรผันทางพันธุกรรม (Genetic Variant) หรือตัวอักษรใน DNA ที่ต่างกันไปในแต่ละคน ส่งผลต่อเซลล์มนุษย์แต่ละชนิดอย่างไร โมเดลเรียนรู้จากข้อมูลระดับเซลล์เดี่ยว (Single-cell) กว่า 107 ล้านเซลล์ ครอบคลุมเนื้อเยื่อ 68 ชนิด และในการทดสอบหนึ่งก็ระบุความแปรผันที่ทำให้การทำงานของยีนเปลี่ยนไปได้มากกว่ารุ่นก่อนเกือบเท่าตัว เป้าหมายคือให้นักวิทยาศาสตร์มีเครื่องมือค้นหาว่าเซลล์ชนิดไหนคือต้นตอของโรค
รุ่นนี้ต่อยอดจาก AlphaGenome รุ่นแรกที่ DeepMind เปิดตัวเมื่อปีที่แล้ว ซึ่งทำนายผลของความแปรผันได้ในระดับเนื้อเยื่อกว้าง ๆ ก่อนจะขยายเป็น AlphaGenome Atlas ฐานข้อมูลคำทำนายของการเปลี่ยนตัวอักษรเดี่ยวทุกแบบที่เป็นไปได้ในจีโนมมนุษย์ รวม 9,000 ล้านแบบ เครื่องมือชุดนี้ช่วยให้นักวิจัยคัดกรองและตีความความแปรผัน จนนำไปสู่การค้นพบทั้งในโรคหายาก ลักษณะทางพันธุกรรมที่ซับซ้อน และชีววิทยาพื้นฐาน ส่วน AlphaGenome 2 คือการซูมจากค่าเฉลี่ยของทั้งเนื้อเยื่อลงไปถึงเซลล์แต่ละชนิดและแต่ละสถานะ
ทำไมต้องอ่าน DNA ทีละชนิดเซลล์ แทนการอ่านทั้งเนื้อเยื่อพร้อมกัน
AlphaGenome รุ่นแรกรับลำดับ DNA ยาวหนึ่งล้านตัวอักษร แล้วทำนายผลการทดลองนับพันรายการจากหลายเนื้อเยื่อไปพร้อมกันในรอบเดียว วิธีนี้ประหยัดก็จริง แต่ทำให้ความสามารถของโมเดลถูกเกลี่ยบางลง จนจับความต่างเล็ก ๆ ระหว่างเซลล์ที่คล้ายกันได้ยาก
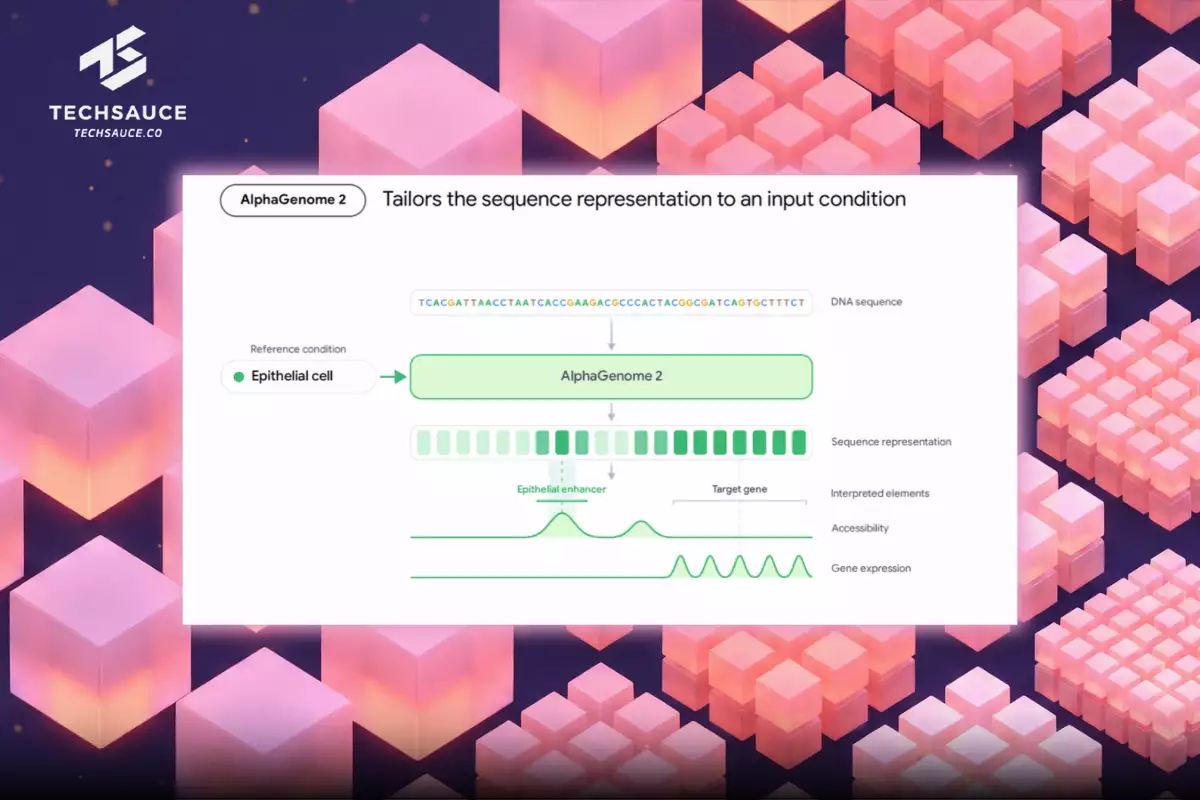
DeepMind จึงรื้อวิธีที่โมเดลมองเซลล์ใหม่ทั้งหมด โดยทำให้ AlphaGenome 2 เป็นโมเดลแบบกำหนดเงื่อนไข (Conditional Model) ที่ทำนายผลของ DNA ทีละเงื่อนไข เช่น เนื้อเยื่อหนึ่ง เซลล์ชนิดหนึ่ง หรือสถานะหนึ่งของเซลล์ เงื่อนไขนั้นถูกป้อนเข้าไปพร้อมลำดับ DNA ในทุกชั้นของโมเดล ผลคือโมเดลเรียนรู้ได้ว่า 'DNA ท่อนเดียวกันถูกเซลล์ต่างชนิดอ่านต่างกันอย่างไร'
ด้านผลลัพธ์ AlphaGenome 2 ยังทำนายค่าหลักชุดเดียวกับรุ่นแรก ได้แก่ ระดับการทำงานของยีน (Gene Expression) การดัดแปลงโปรตีนฮิสโตนที่ DNA พันอยู่ (Histone Modification) และความเปิดของโครมาทิน (Chromatin Accessibility) ซึ่งบอกว่า DNA ช่วงนั้นคลายตัวพอให้เซลล์อ่านได้หรือไม่ แต่รุ่นนี้เพิ่มการทำนายการเติมหมู่เมทิลบน DNA (DNA Methylation) ซึ่งเป็นเครื่องหมายทางเคมีที่มักสัมพันธ์กับการปิดยีน และเป็นข้อมูลที่นักวิจัยขอกันมาก
การออกแบบแบบนี้ยังพาความสามารถใหม่ติดมาด้วย เพราะโมเดลแยกสถานะทางชีวภาพของเซลล์ออกจากผลลัพธ์ที่วัดได้ หากนักวิทยาศาสตร์ป้อนผลการวัดเพียงอย่างเดียว เช่น การทำงานของยีนในระดับเซลล์เดี่ยว AlphaGenome 2 ก็คาดการณ์ค่าที่ยังไม่ได้วัดอย่างความเปิดของโครมาทินต่อได้ ซึ่งช่วยให้นักวิจัยตัดสินใจได้ว่าควรทำการทดลองไหนก่อน
หาจุดเปลี่ยนใน DNA ที่กระทบยีนเจอมากขึ้นเกือบเท่าตัว
ผลของการออกแบบใหม่เห็นชัดในการทดสอบ เมื่อเจอ DNA ช่วงที่ไม่เคยอยู่ในข้อมูลฝึก AlphaGenome 2 อธิบายได้ดีกว่าเดิมอย่างมีนัยสำคัญว่าการทำงานของยีนต่างกันอย่างไรระหว่างเซลล์หลายชนิดในเนื้อเยื่อเดียวกัน และยังติดตามการเปลี่ยนแปลงที่ค่อยเป็นค่อยไปได้ เช่น ช่วงที่เซลล์ต้นกำเนิดเม็ดเลือดเจริญไปเป็นเม็ดเลือดแดงและเซลล์ภูมิคุ้มกันสายต่าง ๆ
ตัวเลขที่ชัดที่สุดมาจากชุดข้อมูล TenK10K ซึ่งเป็นแผนที่ระดับเซลล์เดี่ยวของเซลล์ภูมิคุ้มกัน 28 ชนิด บนชุดข้อมูลนี้ AlphaGenome 2 ระบุความแปรผันที่เป็นต้นเหตุ (Causal Variant) ได้ 30% เทียบกับ 16% ของ AlphaGenome รุ่นแรกที่ปรับจูนด้วยข้อมูลเซลล์เดี่ยวแล้ว และระบุผลต่อยีนพร้อมทิศทางว่าทำให้ยีนทำงานมากขึ้นหรือน้อยลงได้ 43% เทียบกับ 23% โดยยังทำได้ดีกว่าเครื่องมือเฉพาะทางอื่น ๆ ด้วย ความแม่นระดับนี้ช่วยให้นักวิจัยเจอความแปรผันที่เคยถูกมองข้าม
อีกบททดสอบคือโรคลำไส้อักเสบเรื้อรัง หรือ Inflammatory Bowel Disease (IBD) งานวิจัยสำคัญที่ตีพิมพ์ในวารสาร Nature เมื่อปี 2024 พบว่าความแปรผันในสวิตช์ควบคุมยีนที่อยู่ห่างออกไป เป็นตัวขับให้เกิด IBD ผ่านการกระตุ้นยีน ETS2 ให้ทำงานมากเกินไปในแมโครฟาจ (Macrophage) ซึ่งเป็นเซลล์ภูมิคุ้มกันในลำไส้ เมื่อให้ AlphaGenome 2 ทำนายในเซลล์ภูมิคุ้มกันหลายชนิดของลำไส้ โมเดลก็ได้ข้อสรุปเดียวกันจากการคำนวณล้วน ๆ โดยชี้ความแปรผันที่เป็นต้นเหตุได้ถูกตัว และแสดงว่ามันกระตุ้นยีน ETS2 เฉพาะในแมโครฟาจของลำไส้ ขณะที่เซลล์ชนิดอื่นและยีนอื่นแทบไม่ได้รับผลกระทบ
เซลล์ที่ไม่เคยเห็นมาก่อน ก็อ่านได้โดยไม่ต้องเทรนใหม่
ความสามารถของ AlphaGenome 2 ไม่ได้จำกัดอยู่แค่เซลล์ที่อยู่ในข้อมูลฝึก เพราะโมเดลรับข้อมูลการทดลองระดับเซลล์เดี่ยวชุดใหม่ได้ทันทีโดยไม่ต้องเทรนใหม่ นักวิทยาศาสตร์อัปโหลดข้อมูลการทำงานของยีนจากเซลล์เพียงไม่กี่สิบเซลล์ ระบบจะย่อข้อมูลนั้นเป็นตัวแทนสถานะของเซลล์ แล้วใช้เป็นเงื่อนไขให้โมเดลทำนายสถานะที่ไม่เคยเห็นมาก่อน DeepMind ระบุว่าผลที่ได้ทัดเทียมหรือดีกว่าโมเดลที่เทรนหรือปรับจูนกับชุดข้อมูลนั้นโดยตรง
ความสามารถนี้เปิดทางให้ทำนายผลของความแปรผันในเซลล์ที่เปลี่ยนสถานะไปเพราะโรคหรือหลังฉีดวัคซีน ตัวอย่างหนึ่งคือข้อมูลจากงานวิจัยวัคซีนโควิด-19 ชนิด Messenger RNA (mRNA) ที่โมเดลไม่เคยเห็น AlphaGenome 2 แยกทีเซลล์ (T Cell) ที่ถูกวัคซีนกระตุ้นออกจากทีเซลล์ที่อยู่ในภาวะพักได้ และยังพบว่าความแปรผันที่สัมพันธ์กับอาการโควิด-19 รุนแรง รบกวนการทำงานของยีนหนักขึ้นเมื่อเซลล์อยู่ในสถานะถูกกระตุ้น ซึ่งเป็นผลที่จะมองไม่เห็นเลยหากดูแค่เซลล์ที่ยังไม่ถูกกระตุ้น
จุดนี้เองที่ Sarah Teichmann ศาสตราจารย์ด้านเวชศาสตร์เซลล์ต้นกำเนิด มหาวิทยาลัยเคมบริดจ์ และผู้ร่วมก่อตั้งโครงการ Human Cell Atlas ซึ่งเป็นความร่วมมือระดับโลกในการทำแผนที่เซลล์ในร่างกายมนุษย์ มองว่าน่าตื่นเต้นที่สุด โดย Sarah Teichmann ระบุว่า "สิ่งที่ทำให้ AlphaGenome 2 น่าตื่นเต้นคือการปรับตัวเข้ากับข้อมูลเซลล์เดี่ยวชุดใหม่ได้โดยตรงโดยไม่ต้องเทรนใหม่ และทำนายได้ว่าความแปรผันใน DNA ทำงานอย่างไรในสถานะเซลล์ที่เพิ่งวัดมา แม้จะมีตัวอย่างเซลล์เพียงเล็กน้อย"
เชื่อมงานวิจัยพันธุกรรมเข้ากับแผนที่เซลล์ของร่างกาย
จากการอ่านเซลล์รายชนิด DeepMind ขยับไปสู่โจทย์ที่ใหญ่กว่า นั่นคือการเชื่อมพันธุศาสตร์มนุษย์เข้ากับชีววิทยาของเซลล์ งานวิจัยแบบ Genome-Wide Association Study (GWAS) หรือการสแกนทั้งจีโนมเพื่อหาว่าตำแหน่งไหนใน DNA สัมพันธ์กับลักษณะหรือโรคใด ได้พบความแปรผันที่เกี่ยวข้องแล้วหลายพันตำแหน่ง แต่การโยงตำแหน่งเหล่านี้เข้ากับแผนที่เซลล์ระดับเซลล์เดี่ยวที่ใหญ่ขึ้นเรื่อย ๆ ยังเป็นงานยาก
เพื่อให้นักวิจัยไม่ต้องรันการคำนวณขนาดใหญ่เอง DeepMind จึงคำนวณผลทำนายของ AlphaGenome 2 ไว้ล่วงหน้าสำหรับความแปรผันที่สัมพันธ์กับลักษณะต่าง ๆ ครอบคลุมเซลล์และเนื้อเยื่อมนุษย์หลายร้อยแบบ โดยมุ่งแก้ 2 ปัญหาหลัก
ปัญหาแรกคือการหาว่าสวิตช์ตัวไหนคุมยีนตัวไหน ความแปรผันที่เกี่ยวกับโรคจำนวนมากอยู่ในเอนแฮนเซอร์ (Enhancer) หรือสวิตช์ควบคุมยีนที่อยู่ห่างจากตัวยีน จึงตามรอยผลกระทบได้ยาก ประกอบกับการทดลองในห้องแล็บส่วนใหญ่ทำกับเซลล์เพาะเลี้ยงที่เสถียร นักวิทยาศาสตร์จึงมักไม่มี 'ผังการเดินสายของเซลล์จริงในร่างกาย' AlphaGenome 2 ขยายการจับคู่เอนแฮนเซอร์กับยีนไปถึงเซลล์ที่มาจากร่างกายมนุษย์โดยตรง เช่น แอสโตรไซต์ (Astrocyte) ในสมองที่คอยพยุงและปกป้องเซลล์ประสาท ช่วยให้นักวิจัยเชื่อมความแปรผันเข้ากับยีนเป้าหมายในเซลล์ที่โรคเกิดขึ้นจริง
ปัญหาที่สองคือการชี้ตัวต้นเหตุ เพราะ GWAS มักบอกได้แค่ช่วง DNA กว้าง ๆ ที่เกี่ยวกับโรค แต่ระบุความแปรผันที่เป็นต้นเหตุ ยีนเป้าหมาย และชนิดเซลล์ได้ไม่ชัด ในลักษณะที่ซับซ้อนหลายแบบตั้งแต่ส่วนสูงไปจนถึงเบาหวานชนิดที่ 2 คะแนนที่คำนวณไว้ล่วงหน้าของ AlphaGenome 2 ช่วยชี้ความแปรผันและชนิดเซลล์ที่น่าจะเกี่ยวข้องที่สุด และเมื่อโมเดลมั่นใจ ก็ทำนายได้แม่นยำว่าความแปรผันนั้นเร่งหรือลดการทำงานของยีน ซึ่งเป็นเบาะแสสำคัญว่ายีนนั้นมีส่วนก่อโรคอย่างไร
ประโยชน์ข้อนี้ทำให้ฝั่งอุตสาหกรรมยาเริ่มให้ความสนใจ Peter Donnelly ซีอีโอของ Genomics Limited กล่าวว่า
"พันธุศาสตร์มนุษย์เป็นหนึ่งในเครื่องมือที่ทรงพลังที่สุดของการค้นคว้ายา และ GWAS คือหัวใจของงานนี้ แต่การเดินจากสัญญาณความสัมพันธ์ไปสู่สิ่งที่โครงการพัฒนายาต้องการยังเป็นเรื่องยาก โมเดลทำนายลำดับ DNA จึงเป็นเครื่องมือสำคัญที่ช่วยปิดช่องว่างนี้ และ AlphaGenome 2 คือความก้าวหน้าที่น่าประทับใจของวงการ"
พร้อมเผยว่าบริษัทเตรียมนำโมเดลนี้ไปใช้ในแพลตฟอร์ม Mystra
เปิดให้นักวิจัยใช้แล้ว แต่ยังไม่ใช่เครื่องมือวินิจฉัยโรค
ตอนนี้ AlphaGenome 2 เปิดให้ใช้ผ่าน AlphaGenome API สำหรับงานวิจัยที่ไม่ใช่เชิงพาณิชย์ พร้อมบทเรียนแบบโต้ตอบบน Colab ส่วนงานวิจัยเชิงพาณิชย์อยู่ในช่วงทดลองแบบจำกัดสิทธิ์ (Private Preview) และเร็ว ๆ นี้ DeepMind จะปล่อย AlphaGenome 2 Skills บน Google Antigravity แพลตฟอร์มพัฒนาซอฟต์แวร์ที่มี AI ช่วยลงมือทำงาน (Agentic Development Platform) ของ Google เพื่อให้นักวิทยาศาสตร์ใช้โมเดลเฉพาะทางคู่กับ Gemini 4 ในการเร่งงานวิจัย
ในระยะต่อไป DeepMind ร่วมมือกับนักวิจัยของ Wellcome Sanger Institute เพื่อเก็บข้อมูลเซลล์มนุษย์ให้หลากหลายขึ้น ทั้งชนิดเซลล์ เส้นทางการพัฒนาของเซลล์ และเซลล์ที่อยู่ในสภาวะถูกรบกวนแบบต่าง ๆ พร้อมเปิดให้นักวิจัยส่งกรณีใช้งานที่น่าสนใจภายในวันที่ 30 พฤศจิกายนนี้ โดยโครงการที่ได้รับคัดเลือกอาจได้โควตาและเครดิตเพิ่มเติม
ทั้งนี้ DeepMind ย้ำว่า AlphaGenome และ AlphaGenome 2 มีไว้สำหรับงานวิจัยเท่านั้น ยังไม่ผ่านการตรวจสอบหรือรับรองให้ใช้ทางคลินิกหรือวินิจฉัยโรค
ที่มา: Google DeepMind, รายงานทางเทคนิค AlphaGenome 2, Nature
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

สรุปไฮไลต์ LINEDEVCONF 2026 เปิดสนาม AI Agent พร้อมคู่มือชี้ทาง Dev ไทยยุค AI
สรุปไฮไลต์ LINEDEVCONF 2026 เมื่อ LINE เปิดสนามผลักดัน AI Agent ผ่าน LINE BOT MCP Server พร้อมอัปเดตเครื่องมือและแนวทางปรับตัวของคนสายเทคฯ...
 0
Google Labs เปิดตัว Tabletop พื้นที่วางแผนเป็นกลุ่มที่ให้ AI สร้างแผนเที่ยว โพล เครื่องมือหารค่าใช้จ่าย และตารางแข่งขัน ทุกคนเข้ามาแก้พร้อมกันได้แบบ Google Docs เปิดลงชื่อรอคิวในสห...
0

Adobe เปิดตัวฟีเจอร์ AI ครั้งใหญ่ในงาน Adobe MAX ส่ง AI Agent ลง Photoshop, Premiere และ Firefly พร้อมเปิดตัว Local MCP ให้ ChatGPT, Claude และ Gemini สั่งงานได้โดยตรง...
0