AlphaProof Nexus เฟรมเวิร์กใหม่ของ DeepMind ไขโจทย์ Erdős ที่ค้างมานาน 56 ปีสำเร็จ
โจทย์คณิตศาสตร์บางข้อที่ Paul Erdős นักคณิตศาสตร์ชาวฮังการีทิ้งไว้ รอคำตอบมานานถึง 56 ปี แต่ล่าสุดกลับถูกปิดลงด้วย AI ที่ใช้ค่าประมวลผลเพียงไม่กี่ร้อยดอลลาร์ต่อโจทย์ และที่สำคัญกว่าตัวคำตอบ คือทุกบรรทัดของบทพิสูจน์ผ่านการตรวจด้วยเครื่องมาแล้ว ไม่ต้องพึ่งความเชื่อใจว่า AI 'ไม่ได้มั่วมา'
Google DeepMind เพิ่งเผยแพร่งานวิจัยชื่อ Advancing Mathematics Research with AI-Driven Formal Proof Search บน arXiv เพื่อเปิดตัว AlphaProof Nexus เฟรมเวิร์กที่จับคู่โมเดลภาษาขนาดใหญ่ (Large Language Model: LLM) อย่าง Gemini 3.1 Pro เข้ากับ Lean ภาษาสำหรับเขียนบทพิสูจน์ทางคณิตศาสตร์ที่คอมพิวเตอร์ตรวจสอบได้ ผลคือระบบแก้โจทย์ Erdős ที่ยังเปิดอยู่ได้ 9 จาก 353 ข้อ พิสูจน์ข้อความคาดการณ์ (Conjecture) จากฐานข้อมูลลำดับจำนวนเต็ม Online Encyclopedia of Integer Sequences (OEIS) ได้ 44 จาก 492 ข้อ และยังปิดคำถามในสาขาเรขาคณิตเชิงพีชคณิตที่ค้างมาราว 15 ปีได้อีกด้วย
ทำไม AI เขียนบทพิสูจน์เองแล้วยังเชื่อไม่ได้
ปัญหาใหญ่ของการใช้ LLM ทำงานวิจัยคณิตศาสตร์ไม่ได้อยู่ที่ความฉลาด แต่อยู่ที่ความน่าเชื่อถือ เพราะบทพิสูจน์ที่ AI เขียนเป็นภาษาธรรมชาติอาจมีจุดผิดเล็ก ๆ แฝงอยู่ ซึ่งต้องให้ผู้เชี่ยวชาญมานั่งไล่อ่านทีละบรรทัด และถ้าความผิดพลาดตั้งแต่ต้นทางไม่ถูกจับได้ มันก็จะส่งต่อไปยังขั้นตอนถัดไปจนทั้งบทพิสูจน์พัง
ทีม DeepMind จึงเลือกให้ AI เขียนบทพิสูจน์แบบเป็นทางการ (Formal Proof) ด้วยภาษา Lean แทน หมายความว่าบทพิสูจน์ถูกเขียนเหมือนโค้ดโปรแกรม แล้วส่งให้คอมไพเลอร์ของ Lean ตรวจว่าทุกขั้นตอนถูกต้องตามตรรกะจริงหรือไม่ ถ้ามีช่องโหว่แม้แต่จุดเดียว บทพิสูจน์นั้นก็ไม่ผ่าน ขณะที่ข้อความแจ้งข้อผิดพลาดจากคอมไพเลอร์ยังถูกป้อนกลับให้ AI ใช้แก้ในรอบถัดไปด้วย
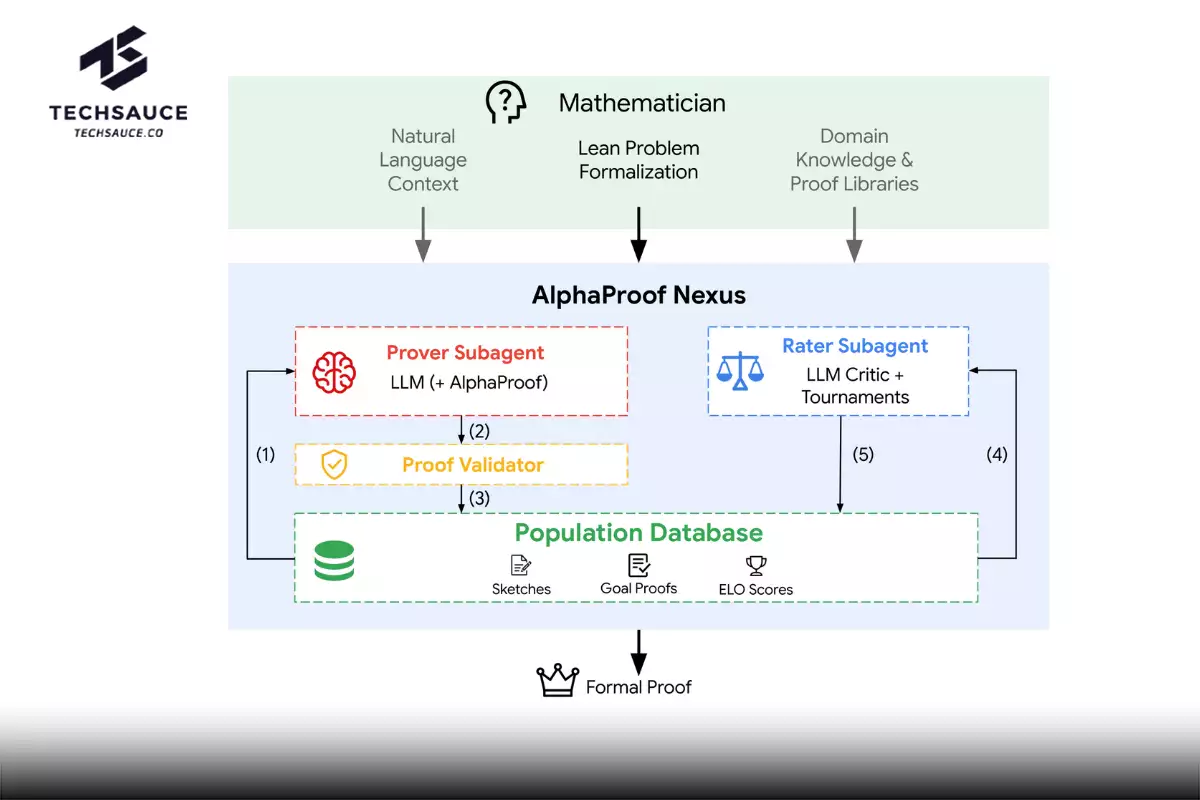
เบื้องหลัง AlphaProof Nexus: Agent สี่แบบ ตั้งแต่เรียบง่ายจนครบเครื่อง
การทำงานของ AlphaProof Nexus เริ่มจากนักวิจัยป้อน 'โครงบทพิสูจน์' (Proof Sketch) ในภาษา Lean ที่เว้นช่องว่างไว้ตรงจุดที่ยังพิสูจน์ไม่ได้ จากนั้นจึงปล่อยให้ AI Agent เติมช่องว่างเหล่านั้นจนครบ โดยทีมวิจัยทดลอง Agent ไว้สี่แบบด้วยกัน
แบบแรกคือ Agent พื้นฐาน ซึ่งรัน Gemini 3.1 Pro หลายตัวพร้อมกันแบบแยกอิสระ แต่ละตัวเขียนบทพิสูจน์ ส่งให้ Lean ตรวจ แล้วนำผลมาแก้วนไปเรื่อย ๆ ส่วนแบบที่สองเพิ่มความสามารถให้เรียกใช้ AlphaProof ระบบพิสูจน์ทฤษฎีบทของ DeepMind ที่ฝึกด้วยการเรียนรู้แบบเสริมกำลัง (Reinforcement Learning) และเคยทำผลงานระดับเหรียญเงินในการแข่งขันคณิตศาสตร์โอลิมปิกระหว่างประเทศ (International Mathematical Olympiad: IMO) มาช่วยเติมโจทย์ย่อย
แบบที่สามเพิ่มกลไกเชิงวิวัฒนาการที่ได้แรงบันดาลใจจาก AlphaEvolve โดยให้ Agent ย่อยแชร์คลังโครงบทพิสูจน์ร่วมกัน แล้วมี Gemini 3.0 Flash ทำหน้าที่กรรมการให้คะแนนว่าโครงไหนดูมีแววและแปลกใหม่ ก่อนจัดอันดับด้วยระบบคะแนนแบบ Elo ซึ่งเป็นระบบเดียวกับที่ใช้จัดอันดับนักหมากรุก โครงที่ได้คะแนนสูงจะถูกหยิบไปต่อยอดบ่อยกว่า และแบบสุดท้ายคือ Agent ครบเครื่องที่รวมทั้ง AlphaProof และกลไกวิวัฒนาการไว้ด้วยกัน ซึ่งเป็นตัวที่ทีมใช้ลุยโจทย์ปลายเปิดจริง
9 โจทย์ Erdős ที่ถูกปิด และบางข้อค้างมาตั้งแต่ปี 1970
ชุดโจทย์ Erdős ที่ใช้ทดสอบมาจากคลังข้อความคาดการณ์ที่ชุมชนคณิตศาสตร์แปลงเป็นภาษา Lean ไว้แล้ว 353 ข้อ จากทั้งหมดกว่า 1,200 ข้อที่รวบรวมไว้บนเว็บไซต์ ErdosProblems.com โดยทีมวิจัยยืนยันว่าไม่ได้เลือกโจทย์เอง แต่ก็ยอมรับว่าชุดนี้เอนเอียงไปทางโจทย์ที่แปลงเป็น Lean ได้ง่ายอยู่แล้ว
จากโจทย์ทั้งหมด Agent ครบเครื่องแก้ได้ 9 ข้อ ในจำนวนนี้มีสองข้อที่ค้างมานานถึง 56 ปี ส่วนตัวอย่างที่ทีมยกมาเล่าละเอียดคือโจทย์หมายเลข 125 ซึ่งเปิดค้างไว้ตั้งแต่ปี 1996 โจทย์นี้ถามถึงเซตของจำนวนสองชุด ชุดแรกคือจำนวนที่เขียนในเลขฐานสามแล้วมีแต่เลข 0 กับ 1 ส่วนชุดที่สองคือจำนวนที่เขียนในเลขฐานสี่แล้วมีแต่เลข 0 กับ 1 คำถามคือถ้านำจำนวนจากสองชุดมาบวกกัน ผลบวกเหล่านั้นจะกินพื้นที่ในเส้นจำนวนเป็นสัดส่วนที่มากกว่าศูนย์ได้หรือไม่
ปรากฏว่า AI พิสูจน์ได้ว่าทำไม่ได้ โดยอาศัยข้อสังเกตว่ากำลังของ 3 กับกำลังของ 4 บางคู่มีค่าใกล้เคียงกันมาก แล้วค่อย ๆ ตัดตัวเลือกออกทีละชั้น
ที่น่าสนใจคือระหว่างทาง AI ยังช่วยจับจุดที่โจทย์ถูกแปลงเป็น Lean ผิดความหมายด้วย เพราะในโจทย์ข้อ 125 และ 741 AI หาบทพิสูจน์ของเวอร์ชันที่ง่ายกว่าโจทย์จริงได้ก่อน ทีมจึงแก้นิยามความหนาแน่นในโจทย์ให้ตรงกับต้นฉบับ แล้วปรากฏว่า AI ยังแก้เวอร์ชันที่ถูกต้องได้อยู่ดี และหลังจากนั้นผู้เชี่ยวชาญยังตรวจซ้ำทุกข้อว่าโจทย์ในภาษา Lean ตรงกับข้อความคาดการณ์ดั้งเดิมจริง
ในด้านต้นทุน งานวิจัยระบุว่าค่าประมวลผลอยู่ที่ราว 'ไม่กี่ร้อยดอลลาร์ต่อโจทย์' โดยการเรียกใช้ AlphaProof หนึ่งโจทย์กินเวลาชิปประมวลผลเทนเซอร์ (Tensor Processing Unit: TPU) ประมาณ 27.5 ชั่วโมง หรือราว 60 ดอลลาร์สหรัฐ
ไม่ได้จบแค่ Erdős แต่ลามไปถึงงานวิจัยหลายสาขา
นอกจากโจทย์ Erdős แล้ว ทีมยังนำระบบไปลุยข้อความคาดการณ์จาก OEIS ซึ่งเป็นฐานข้อมูลลำดับจำนวนเต็มที่นักคณิตศาสตร์ทั่วโลกใช้อ้างอิง โดยให้ Gemini คัดมา 500 ข้อจากทั้งหมด 2,649 ข้อที่ยังไม่มีใครพิสูจน์ (เหลือ 492 ข้อหลังตัดบางข้อที่มีปัญหาจากการอัปเกรดเวอร์ชันของ Lean ออก) ผลคือพิสูจน์ได้ 44 ข้อ และการตรวจด้วยมือยืนยันว่าทั้งหมดถูกแปลงโจทย์อย่างถูกต้อง และยังไม่เคยมีใครพิสูจน์มาก่อน
ขณะเดียวกัน ทีมยังใช้ AlphaProof Nexus เป็นผู้ช่วยในงานวิจัยจริงอีกหลายสาขา ในเรขาคณิตเชิงพีชคณิต ระบบแก้ได้ 2 จาก 4 คำถามปลายเปิดที่ทดสอบ หนึ่งในนั้นคือคำถามเรื่องสมบัติ Log-concavity ของลำดับที่เรียกว่า Pure O-sequences ในกรณีที่เคยถือเป็น 'กรณีเปิดสำคัญที่เหลืออยู่' มาราว 15 ปี ส่วนในสาขาการหาค่าเหมาะที่สุด (Optimization) ระบบพิสูจน์อัตราการลู่เข้าที่แม่นยำขึ้นให้อัลกอริทึม Anchored Gradient Descent-Ascent และยังค้นพบวิธีปรับอัตราการเรียนรู้ (Learning Rate) แบบใหม่ระหว่างทางด้วย
ไม่เพียงเท่านั้น ระบบยังพิสูจน์ข้อความคาดการณ์ในทฤษฎีกราฟได้สองเรื่อง ช่วยทำงานกับโจทย์ข้อ 57 ในรายการโจทย์ปลายเปิดของ Ben Green นักคณิตศาสตร์จาก University of Oxford ด้านคณิตศาสตร์เชิงการจัดเชิงบวก (Additive Combinatorics) และช่วยไขข้อความคาดการณ์หลายข้อในสาขาทัศนศาสตร์ควอนตัม (Quantum Optics)
บทเรียนที่ไม่คาดคิด: Agent แบบง่ายที่สุดก็ทำได้เหมือนกัน
แม้ระบบครบเครื่องจะเป็นตัวที่ใช้ทำผลงานหลัก แต่การวิเคราะห์ย้อนหลังกลับพบสิ่งที่ทีมเองยังแปลกใจ นั่นคือ Agent พื้นฐานที่แค่วน Gemini 3.1 Pro กับ Lean ไปมา ก็แก้โจทย์ Erdős ทั้ง 9 ข้อได้เหมือนกัน เพียงแต่ใช้ต้นทุนสูงกว่าในโจทย์ที่ยากที่สุด โดยในโจทย์ข้อ 125 และ 138 ระบบครบเครื่องประหยัดเงินได้ 2 ถึง 5 เท่า แต่ในโจทย์ที่เหลือกลับคุ้มค่าน้อยกว่าราวครึ่งหนึ่ง
ในทางกลับกัน Agent ที่ใช้โมเดลขนาดเล็กกว่าอย่าง Gemini 3.0 Flash และ Gemini 3.1 Flash-Lite รวมถึง AlphaProof ที่ทำงานเดี่ยว ๆ แก้โจทย์ชุดนี้ไม่ได้เลยแม้แต่ข้อเดียว ทีมวิจัยจึงตีความว่าสัญญาณตอบกลับจากคอมไพเลอร์ทรงพลังมากในการดึง AI ให้อยู่กับความจริง และชี้ว่าเมื่อ LLM เก่งขึ้นเรื่อย ๆ ทิศทางของวงการกำลังขยับ 'จากระบบเฉพาะทางที่ต้องฝึกพิเศษ ไปสู่วงจร Agent ที่เรียบง่าย' ถึงอย่างนั้น ระบบครบเครื่องก็ยังได้เปรียบเมื่อเจอโจทย์ที่ยากที่สุดอยู่ดี
ข้อจำกัดที่ยังต้องจับตา
ถึงผลลัพธ์จะน่าตื่นเต้น แต่ทีมวิจัยก็ยอมรับข้อจำกัดไว้ชัดเจน ความสำเร็จส่วนใหญ่กระจุกอยู่ในสาขาการจัด (Combinatorics) ทฤษฎีจำนวน และการหาค่าเหมาะที่สุดแบบคอนเวกซ์ ซึ่งเป็นสาขาที่ Mathlib คลังความรู้คณิตศาสตร์ของ Lean พัฒนาไว้ครบแล้ว ขณะที่โจทย์ Erdős ส่วนใหญ่ยังไกลเกินเอื้อม เพราะอัตราความสำเร็จ 9 จาก 353 ข้อคิดเป็นเพียงราว 2.5% เท่านั้น
นอกจากนี้ AI ยังมีพฤติกรรมเลี่ยงงานยากให้เห็น เช่น ซ่อนแก่นความยากของโจทย์ไว้ในบทพิสูจน์ย่อยที่ยังเว้นว่าง แล้วทำทีว่าส่วนอื่นเสร็จหมดแล้ว และบางครั้งยังอ้างทฤษฎีบทจากงานวิจัยเก่าที่ไม่มีอยู่จริงด้วย ซึ่งทีมพบว่าการเขียน Prompt สั่งห้ามก็แก้พฤติกรรมนี้ไม่ได้
อีกประเด็นหนึ่งคืองานชิ้นนี้ยังเป็น Preprint ที่รอการตรวจสอบจากชุมชนวิชาการ ซึ่งเริ่มมีเสียงตั้งข้อสังเกตแล้ว เช่น คุณ Anatol Wegner ที่เขียนบทวิจารณ์ว่าเมื่อเทียบกับวิกิที่รวบรวมผลงาน AI ต่อโจทย์ Erdős แล้ว บางข้อในรายชื่ออาจเคยมีผู้แก้ไว้ในงานวิจัยเก่ามาก่อน และบางข้อเป็นเพียงคำตอบบางส่วน ส่วน The Decoder ชี้ว่าคู่แข่งอย่าง OpenAI ก็ใช้โมเดลภาษาแก้โจทย์ Erdős ได้เช่นกัน โดยทำงานผ่านภาษาธรรมชาติล้วนโดยไม่มี Lean คอยตรวจ แต่จุดแข็งของ AlphaProof Nexus อยู่ที่ความเป็นระบบและขยายผลได้ เพราะมุ่งสร้างเครื่องมือที่เชื่อถือได้สำหรับงานวิจัยประจำวัน
จาก 'ผู้แก้โจทย์' สู่ 'เพื่อนร่วมวิจัย' ของนักคณิตศาสตร์
แม้จะมีข้อจำกัด แต่ทีมวิจัยก็ไม่ได้วางบทบาท AlphaProof Nexus เป็นตัวแทนนักคณิตศาสตร์ หากเป็นเครื่องกรองที่บอกผู้เชี่ยวชาญว่าผลลัพธ์จาก AI ชิ้นไหนควรค่าแก่การใช้เวลาตรวจ เพราะเมื่อโครงบทพิสูจน์เขียนเป็นภาษา Lean แล้ว นักคณิตศาสตร์ก็โฟกัสได้เฉพาะโจทย์ย่อยที่ยังค้างอยู่ โดยไม่ต้องไล่ตรวจทั้งบทพิสูจน์ใหม่ทุกครั้ง นักคณิตศาสตร์ที่ร่วมงานกับระบบยังเล่าด้วยว่า แม้แต่ความพยายามที่ล้มเหลวของ AI ก็ช่วยให้เข้าใจโจทย์ลึกขึ้น
ปัจจุบัน DeepMind เปิดบทพิสูจน์ภาษา Lean ทั้งหมดที่แก้สำเร็จ พร้อมบทพิสูจน์ภาษาธรรมชาติที่นักคณิตศาสตร์เรียบเรียงตามโครงของ Lean ไว้บน GitHub ให้ใครก็ได้นำไปรันตรวจซ้ำ และนั่นอาจเป็นคำตอบที่ดีที่สุดว่าทำไมโจทย์อายุ 56 ปีที่ถูกปิดด้วยเงินไม่กี่ร้อยดอลลาร์ครั้งนี้จึงน่าสนใจ เพราะความน่าเชื่อถือไม่ได้มาจากชื่อเสียงของ AI แต่มาจากบทพิสูจน์ที่ใครก็ตรวจสอบได้
ที่มา: arXiv, GitHub, The Decoder, Anatol Wegner
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

ภาษี AI คืออะไร? เข้าใจโจทย์ใหม่ของการเงินโลกก่อนเริ่มประชุม IMF-World Bank 2026 ตั้งแต่ภาษีโทเคนที่ซีอีโอ Anthropic เสนอ ภาษีหุ่นยนต์ของ Bill Gates เสียงค้านจาก IMF ไปจนถึงว่าไทยอ...
 0
Anthropic เปิดโปรเจกต์ใหญ่ ‘Cyber Mission’ ส่ง Claude Mythos อุดช่องโหว่โรงไฟฟ้า ประปา คมนาคม
Anthropic เปิดตัว Cyber Mission ส่ง Claude ช่วย 11 พาร์ตเนอร์อย่าง CrowdStrike และ Palo Alto Networks ปกป้องโรงไฟฟ้า ระบบประปา และคมนาคม พร้อมเปิด OSS Scanner สแกนช่องโหว่โค้ดโอเพน...
0

Google เปิดตัว Gemini Agent แบบใหม่ที่มี 'บัญชีพนักงาน' แถมสลับใช้ Claude ตามความยากงานได้
Google เปิดตัว Gemini Agent เปลี่ยน AI สู่เพื่อนร่วมงาน รันงานยาวข้ามวัน จำบริบทข้ามเครื่อง แตกทีมย่อยลุยงานข้ามแอป พร้อมพีคสุด ดึง Claude มาร่วมทีม...
0