Microsoft AI เปิดตัวโมเดลถอดเสียงเรียลไทม์ Transcribe-2-Streaming และ Voice-2.1 ตรวจจับภาษาและแปลอัตโนมัติ ไม่ต้องรอพูดจบ
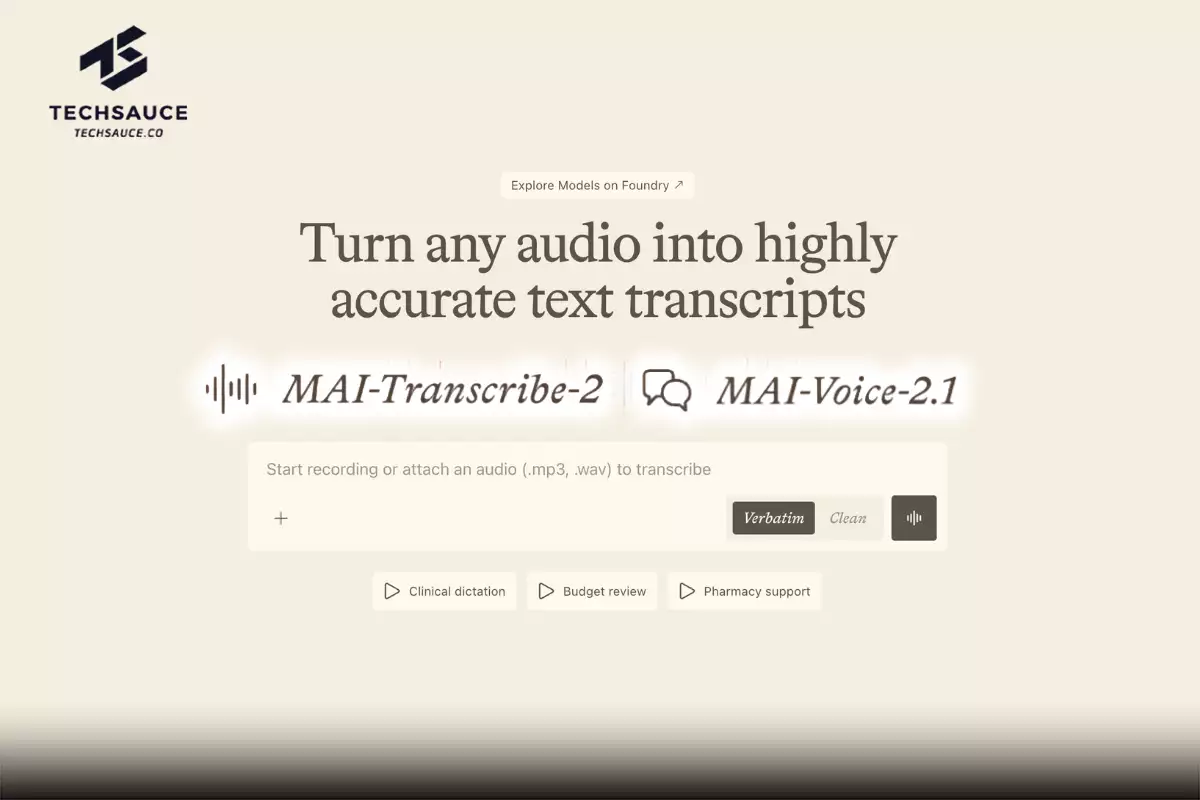
Microsoft AI (MAI) เปิดตัว MAI-Transcribe-2-Streaming โมเดลถอดเสียงพูดเป็นข้อความแบบเรียลไทม์ตัวแรกของบริษัท และขึ้นอันดับ 1 ด้านความแม่นยำบน Artificial Analysis แพลตฟอร์มจัดอันดับโมเดล AI อิสระได้ตั้งแต่เปิดตัว จุดเด่นคือโมเดลไม่ต้องรอให้คนพูดจบประโยค แต่ทยอยแปลงเสียงเป็นข้อความไปพร้อมกับที่ได้ยิน รองรับทั้งหมด 60 ภาษา
พร้อมกันนี้ Microsoft AI ยังเปิดตัวโมเดลสร้างเสียงพูดจากข้อความ (Text-to-Speech) อีกสองรุ่น ได้แก่ MAI-Voice-2.1 ที่ใช้เสียงเดียวพูดได้หลายภาษาด้วยสำเนียงเจ้าของภาษา และ MAI-Voice-2.1-Flash รุ่นที่เร็วกว่าและถูกกว่า ทั้งสามโมเดลออกแบบมาให้ใช้ร่วมกัน เพื่อให้นักพัฒนาสร้างเอเจนต์เสียง (Voice Agent) หรือ AI ที่คุยโต้ตอบกับคนด้วยเสียงได้อย่างเป็นธรรมชาติ ทั้งฟังแม่นและพูดชัด
ถอดเสียงได้ตั้งแต่คนยังพูดไม่จบ
หลักการทำงานของ MAI-Transcribe-2-Streaming คือการเขียนร่างไปก่อน หลังได้ยินเสียงเพียงราว 100 มิลลิวินาที โมเดลจะส่งข้อความฉบับร่าง (Partials) ออกมาทันที แล้วแก้คำให้ถูกต้องขึ้นเรื่อย ๆ เมื่อได้ยินบริบทมากขึ้น ก่อนสรุปเป็นข้อความฉบับจริงที่ไม่เปลี่ยนอีก ระหว่างนั้นโมเดลยังแยกได้เองว่าผู้พูดใช้ภาษาอะไร โดยไม่ต้องตั้งค่าภาษาไว้ก่อน
ข้อความฉบับร่างนี้เองที่ทำให้แอปพลิเคชันเริ่มทำงานได้เร็วขึ้น เอเจนต์เสียงไม่ต้องรอให้ผู้ใช้พูดจบ แต่เริ่มคิดหาคำตอบหรือเรียกใช้เครื่องมือได้ตั้งแต่กลางประโยค ส่วนงานที่ต้องแสดงข้อความแบบสด ๆ อย่างการพิมพ์ด้วยเสียงหรือซับไตเติลแบบเรียลไทม์ ผลทดสอบภายในของ Microsoft AI พบว่าคำพูดขึ้นเป็นตัวหนังสือเร็วกว่าคู่แข่งที่ใกล้เคียงที่สุด 2 เท่า
เร็วขึ้น แต่ความแม่นยำไม่ตก
แต่การถอดเสียงเร็วจะไม่มีประโยชน์ถ้าถอดผิด และนี่คือจุดที่ MAI-Transcribe-2-Streaming ทำได้ดี บน Artificial Analysis โมเดลได้อันดับ 1 ด้านความแม่นยำ ทั้งข้อความฉบับร่างและฉบับจริง
เมื่อวัดความแม่นยำควบคู่กับความเร็ว โมเดลยังอยู่ในกลุ่มที่สมดุลที่สุด (Pareto Frontier) หมายความว่าไม่มีโมเดลไหนที่ทั้งแม่นกว่าและเร็วกว่าในเวลาเดียวกัน Microsoft AI จึงบอกว่าความแม่นยำที่สูงขึ้นไม่จำเป็นต้องแลกกับการตอบสนองที่ช้าลง ส่วนราคาช่วงเปิดตัวอยู่ที่ 0.54 ดอลลาร์ต่อเสียง 1 ชั่วโมง ไปจนถึงสิ้นปีนี้
MAI-Voice-2.1 เปลี่ยนภาษาได้ แต่เสียงยังเป็นคนเดิม
เมื่อฝั่งการฟังพร้อมแล้ว อีกครึ่งหนึ่งของบทสนทนาคือการพูด MAI-Voice-2.1 เป็นโมเดลสร้างเสียงพูดที่รองรับหลายภาษาได้ดีที่สุดของ Microsoft AI ในตอนนี้ ครอบคลุม 23 ภาษาและ 26 สำเนียงตามประเทศ (Locale) เช่น ภาษาอังกฤษแบบอเมริกันกับแบบบริติช
ความพิเศษคือเสียงหนึ่งเสียงพูดได้ทุกภาษาในสำเนียงของเจ้าของภาษา ถ้าให้พูดภาษาอังกฤษ ต่อด้วยจีนกลาง แล้วเปลี่ยนเป็นเยอรมัน คนฟังจะยังรู้ว่าเป็นเสียงของคนเดิม แต่สำเนียงจะเปลี่ยนไปตามภาษานั้นอย่างเป็นธรรมชาติ ไม่ใช่พูดทุกภาษาด้วยสำเนียงเดียวกันหมด
สำหรับธุรกิจ นี่หมายความว่าแบรนด์ใช้เสียงประจำแบรนด์เพียงเสียงเดียวได้ในทุกตลาด แอปติวหนังสือสลับภาษากลางบทเรียนได้โดยไม่ต้องเปลี่ยนเสียงผู้สอน และผู้ช่วย AI ตอบกลับเป็นภาษาเดียวกับที่ผู้ใช้พูดมาได้ด้วยเสียงเดิม MAI-Voice-2.1 คิดราคา 22 ดอลลาร์ต่อ 1 ล้านตัวอักษร
MAI-Voice-2.1-Flash รุ่นเร็วและถูก สำหรับงานปริมาณมาก
ถ้างานต้องการความเร็วและต้องสร้างเสียงจำนวนมาก Microsoft AI มี MAI-Voice-2.1-Flash ให้เลือก รุ่นนี้รองรับภาษาเท่ากับ MAI-Voice-2.1 และใช้เสียงเดียวพูดข้ามภาษาได้เหมือนกัน แต่ปรับให้ตอบสนองเร็วขึ้น สร้างเสียงยาว 45 วินาทีได้โดยใช้เวลาตอบสนองรวม (End-to-end Latency) เพียง 150 มิลลิวินาที
ความเร็วที่เพิ่มขึ้นยังมาพร้อมราคาที่ลดลง Flash ประมวลผลเร็วขึ้น 55% และถูกกว่าโมเดลระดับเดียวกันราว 60% ด้วยราคา 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร ซึ่ง Microsoft AI บอกว่าเป็นราคาที่ดีที่สุดในกลุ่ม เมื่อทั้งเร็ว เสียงดี และคุ้มค่า Flash จึงเหมาะจะใช้คู่กับ MAI-Transcribe-2-Streaming ในการสร้างเอเจนต์เสียงที่คุยได้ลื่นไหล
ทั้งสองรุ่นยังโคลนเสียง (Voice Cloning) ได้ทุกภาษาที่รองรับ โดยใช้ตัวอย่างเสียงเพียงไม่กี่วินาที แบรนด์จึงนำเสียงของตัวเองมาใช้ได้ง่าย และเพื่อป้องกันการนำไปใช้ในทางที่ผิด โมเดลจึงมีระบบตรวจสอบความยินยอมของเจ้าของเสียง (Consent Guardrails) ติดมาด้วย
ทำไมต้องใช้คู่กัน เพราะเอเจนต์เสียงต้องแข่งกับเวลา
เหตุผลที่ Microsoft AI เปิดตัวโมเดลฟังและโมเดลพูดพร้อมกัน มาจากวิธีทำงานของเอเจนต์เสียง ทุกครั้งที่คุยกับคน เอเจนต์ต้องฟัง ทำความเข้าใจ ตัดสินใจ แล้วพูดตอบ และต้องทำทั้งหมดให้จบเร็วพอที่คนฟังยังรู้สึกว่ากำลังคุยกันอยู่ ถ้าขั้นไหนช้า เวลาที่เหลือให้ขั้นอื่นก็น้อยลง
การใช้ MAI-Transcribe-2-Streaming คู่กับ MAI-Voice-2.1-Flash จึงช่วยประหยัดเวลาได้ทั้งตอนฟังและตอนพูด เวลาที่เหลือเปิดโอกาสให้เอเจนต์คิดวิเคราะห์ เรียกใช้เครื่องมือ และตรวจคำตอบของตัวเองได้มากขึ้น โดยที่จังหวะการคุยยังเป็นธรรมชาติเหมือนคนคุยกัน
จากชุดโมเดลนี้ นักพัฒนาสร้างงานได้แล้วหลายแบบ เช่น เอเจนต์บริการลูกค้าที่ถอดคำพูดไปพร้อมกับที่ลูกค้าพูด เริ่มจัดการให้ก่อนลูกค้าพูดจบ แล้วตอบกลับด้วยเสียงที่เป็นธรรมชาติ ผู้ช่วยหลายภาษาที่รู้เองว่าผู้ใช้พูดภาษาอะไร แล้วตอบกลับได้ใน 23 ภาษาด้วยเสียงเดิมและสำเนียงเจ้าของภาษา รวมถึงสื่อการเรียนรู้และสื่อแบบโต้ตอบที่ใช้หลายเสียงแยกตามตัวละคร ทั้งการติวหนังสือ การเล่นบทบาทสมมติ การจำลองสถานการณ์ และการเล่าเรื่อง
ลองได้แล้วผ่านเดโม Chatter
การทำงานจริงเมื่อทั้งสามโมเดลทำงานร่วมกันดูได้จาก Chatter เดโมเอเจนต์เสียงที่ Microsoft AI ทำไว้ใน MAI Playground
สำหรับการใช้งานจริง ทั้งสามโมเดลเปิดให้ใช้แล้วผ่าน Microsoft Foundry, MAI Playground, Vercel และ Azure Voice Live ส่วน LiveKit จะตามมาเร็ว ๆ นี้ นอกจากนี้ MAI-Voice-2.1 และ MAI-Voice-2.1-Flash ยังใช้ผ่าน OpenRouter ได้ด้วย
ที่มา: Microsoft AI
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

Anthropic เปิดตัว Claude Duet agent เชิงรุกที่เฝ้าแอปที่เชื่อมไว้ ทำงานต่อบนเครื่องเสมือนแม้ปิดคอม และถามก่อนส่งข้อความ จ่ายเงิน เซ็นเอกสาร หรือลบข้อมูล เปิดทดลองผ่าน waitlist ให้ผ...
 0

ถ้าสร้างบริษัทวันนี้ จะออกแบบแบบเดิมไหม โจทย์ที่ กระทิง-เรืองโรจน์ พูนผล ฝากผู้นำองค์กรไทย
คุณกระทิง เรืองโรจน์ พูนผล ฝากผู้นำองค์กรบนเวที Nation Forum 2027 ให้เลิกเอา AI ไปเร่งงานแบบเดิม ถามว่าถ้าสร้างบริษัทวันนี้ที่มี AI ตั้งแต่วันแรก จะออกแบบแบบเดิมไหม พร้อมเรื่อง Age...
0

คุณซิกเวเล่าว่าความสามารถของ AI เพิ่มขึ้นเท่าตัวทุก 3 เดือน ซึ่งเร็วกว่าการเปลี่ยนแปลงของเทคโนโลยีครั้งไหน ๆ เร็วกว่าตอนอินเทอร์เน็ตเกิดขึ้นเสียอีก และยังไม่มีใครรู้แน่ว่าจะไปจบที่...
0