Google เปิดตัว Gemini 3.8 Live AI ที่พูดไปคิดไปได้แบบมนุษย์ รองรับการแปลสดถึง 97 ภาษาทั่วโลก
Google เพิ่งปล่อยโมเดลเสียงสองตัวใหม่ออกมาพร้อมกัน คือ Gemini 3.8 Live ที่ออกแบบมาให้รันงานจำนวนมากโดยคุมต้นทุนได้ กับ Gemini 3.8 Live Extended Thinking ที่เน้นงานซับซ้อนซึ่งต้องคิดหลายขั้น จุดร่วมของทั้งคู่คือการย่นเวลาคิดให้เข้าใกล้เรียลไทม์ จนคุยโต้ตอบได้ต่อเนื่องโดยบทสนทนาไม่สะดุดระหว่างรอโมเดลประมวลผล
ปัญหาใหญ่ที่สุดของผู้ช่วยเสียงอัตโนมัติ (Voice Agents) มาตลอดคือช่องว่างระหว่างการฟังจบกับการตอบ ยิ่งโมเดลคิดละเอียด ความหน่วง (Latency) ยิ่งสูง จนคนคุยรู้สึกว่ากำลังคุยกับเครื่อง สิ่งที่ Google พยายามแก้ในรุ่นนี้จึงไม่ใช่แค่ความฉลาด แต่เป็นจังหวะของการสนทนา ทั้งการรับภาพเข้ามาเป็นบริบทระหว่างคุย การทำงานเบื้องหลังไปพร้อมกับพูด และการส่งเสียงตอบรับก่อนคำตอบจริงจะเสร็จ
สำหรับนักพัฒนาและองค์กร ทั้งสองตัวถูกวางเป็นชิ้นส่วนตั้งต้นสำหรับสร้างผู้ช่วยเสียงที่ใช้งานจริงในระดับโปรดักชัน ส่วนฝั่งผู้ใช้ทั่วไปจะได้สัมผัสผ่านแอป Gemini, Google Workspace และ Search
คะแนนที่พา Extended Thinking ขึ้นอันดับหนึ่งบนดัชนีคุณภาพเสียง
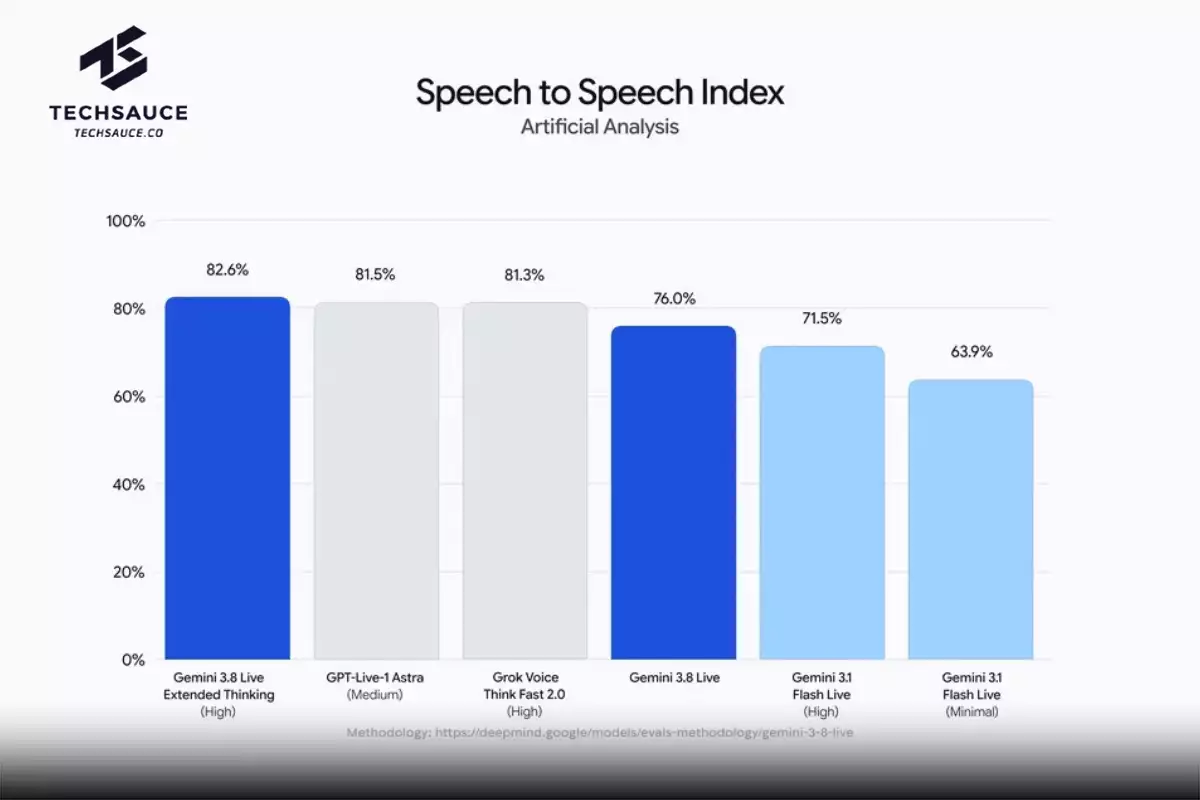
Gemini 3.8 Live Extended Thinking คว้าอันดับหนึ่งบนดัชนีคุณภาพการสนทนาเสียงต่อเสียง (Speech to Speech Quality Index) ของ Artificial Analysis ด้วยคะแนน 82.6 และนำในหมวดการทำงานให้สำเร็จแบบเอเจนต์ ทั้งชุดทดสอบ τ-Voice ที่ 68.6% และ τ-Voice-banking ของ Sierra ที่ 35.1% ซึ่งจำลองงานบริการลูกค้าสายธนาคาร ส่วนด้านการให้เหตุผลทำได้ 97.7% บน Big Bench Audio โดย Google ระบุว่ายังคงราคาไว้ในระดับที่แข่งขันได้กับโมเดลระดับแนวหน้าตัวอื่น
ฝั่ง Gemini 3.8 Live เน้นคนละโจทย์ ผลที่ออกมาคืออันดับสองบน Speech Agent Arena ซึ่งวัดจากความชอบของผู้ใช้ที่ได้ลองคุยจริง คู่กับต้นทุนต่อการใช้งานที่ต่ำ ทำให้เหมาะกับงานที่ต้องเปิดใช้พร้อมกันจำนวนมาก
อีกชุดทดสอบที่ Google หยิบมาอ้างคือ EVA-Bench ของ ServiceNow ที่ออกแบบมาประเมินผู้ช่วยเสียงโดยเฉพาะ ผลที่ได้คือโมเดลทั้งสองขยับเส้นขอบพาเรโต (Pareto Frontier) ของงานที่มีขั้นตอนซับซ้อนออกไป หรือพูดอีกแบบคือทำคะแนนความแม่นยำได้สูงขึ้นโดยไม่ต้องแลกกับคุณภาพการสนทนา ซึ่งเป็นสองอย่างที่มักต้องเลือกอย่างใดอย่างหนึ่ง โดยผลนี้รันบน Live API บน Gemini Enterprise Agent Platform
สลับ 97 ภาษากลางประโยค และทำงานเบื้องหลังไปพร้อมกับคุย
ความสามารถที่เห็นผลชัดที่สุดของ Gemini 3.8 Live คือการรับภาพเข้ามาประมวลผลแบบเกือบเรียลไทม์ ทำให้คำตอบอิงกับสิ่งที่กล้องเห็นตรงหน้าได้ ไม่ใช่เดาจากคำอธิบายของผู้ใช้อย่างเดียว
อีกจุดคือภาษา โมเดลรองรับ 97 ภาษา และตรวจจับเองได้ว่าคู่สนทนาเปลี่ยนภาษาระหว่างทาง แล้วสลับตามให้โดยไม่ต้องตั้งค่าใหม่ ซึ่งตรงกับพฤติกรรมจริงของคนที่พูดสลับภาษาในประโยคเดียว
ส่วนที่ช่วยเรื่องจังหวะมากที่สุดคือการเรียกใช้เครื่องมือและ API ได้ในเบื้องหลังโดยที่บทสนทนายังเดินต่อ โมเดลตอบรับคำขอ คุยเรื่องอื่นต่อได้ แล้วค่อยกลับมาแจ้งผลเมื่องานเบื้องหลังเสร็จ แทนที่จะปล่อยให้อีกฝ่ายฟังความเงียบระหว่างรอ
เมื่อโมเดลคิดหนัก แต่ไม่ปล่อยให้สายเงียบ
Gemini 3.8 Live Extended Thinking แก้โจทย์เดียวกันด้วยวิธีที่ต่างออกไป คือให้กระบวนการคิดกับการพูดเดินไปพร้อมกัน ระหว่างที่โมเดลกำลังไล่เหตุผลหลายขั้น มันจะส่งสัญญาณทางเสียงออกมาก่อน เช่น 'Let me check that…' เพื่อบอกว่ารับคำขอแล้วและกำลังจัดการอยู่ จากนั้นจะเล่าความคืบหน้าเป็นระยะระหว่างที่งานหลายขั้นตอนทยอยเดินอยู่เบื้องหลัง
ผลลัพธ์คือผู้ใช้ได้ความฉลาดระดับที่รับงานซับซ้อนไหว โดยไม่ต้องแลกกับบทสนทนาที่ขาดเป็นช่วง ๆ ซึ่งเป็นข้อแลกเปลี่ยนที่โมเดลเสียงรุ่นก่อนหน้ามักหนีไม่พ้น
แพลตฟอร์มที่รอรับอยู่แล้ว ตั้งแต่ LiveKit ถึง Vercel
ทั้งสองโมเดลเปิดให้เรียกใช้ผ่าน Gemini Live API และมีแพลตฟอร์มสำหรับนักพัฒนาที่รองรับอยู่แล้วหลายราย ทั้ง Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel และ Vision Agents ซึ่งช่วยจัดการโครงสร้างพื้นฐานการสตรีมสื่อแบบเรียลไทม์ให้เบื้องหลัง เพื่อให้นักพัฒนาโฟกัสที่ประสบการณ์ผู้ใช้อย่างเดียว
ฝั่งองค์กร Google ระบุว่ากำลังทำงานร่วมกับ Salesforce, Genspark และ Lumeris ซึ่งให้ความสนใจกับความหน่วงที่ต่ำ ความลื่นไหลของบทสนทนา และความสามารถในการเรียกใช้เครื่องมือของโมเดลชุดนี้
เสียงทุกไฟล์ถูกฝังลายน้ำไว้ตั้งแต่ต้นทาง
เสียงทั้งหมดที่สร้างจากผลิตภัณฑ์ AI ของ Google จะถูกฝังลายน้ำดิจิทัล (SynthID) ไว้ในไฟล์เสียงโดยตรง เป็นลายน้ำที่หูคนฟังไม่ได้ยิน แต่ระบบตรวจสอบย้อนกลับได้ว่าเสียงนั้นมาจาก AI ซึ่งเป็นกลไกที่วางไว้รับมือกับการนำเสียงสังเคราะห์ไปใช้บิดเบือนข้อมูล รายละเอียดด้านความปลอดภัยและความรับผิดชอบทั้งหมดอยู่ในเอกสารข้อมูลโมเดล (Model Card) ที่ Google เผยแพร่คู่กัน
ตอนนี้ทั้งสองโมเดลเริ่มทยอยเปิดให้ใช้งานแล้ว ฝั่งนักพัฒนาเรียกใช้ได้ผ่าน Gemini API และ Google AI Studio ฝั่งองค์กรอยู่ในสถานะพรีวิวแบบจำกัดบน Gemini Enterprise และจะตามมาบน Gemini Enterprise for Customer Experience ส่วนผู้ใช้ทั่วไปจะเจอ Gemini 3.8 Live ใน Search Live ขณะที่ Extended Thinking จะอยู่ใน Gemini Live รวมถึงใน Docs สำหรับผู้สมัครแพ็กเกจ Google AI Pro และ Ultra ที่ใช้ Workspace และใน Gmail กับ Keep สำหรับผู้สมัครแพ็กเกจ Google AI ทุกระดับ
ที่มา: Google, Google AI for Developer, Artificial Analysis, ServiceNow EVA-Bench
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

บีโอไอเปิดเผยหลังเยี่ยมชมและหารือกับผู้บริหาร Agoda ที่ One Bangkok เมื่อวันที่ 6 ตุลาคม 2569 ว่าบริษัทใช้กรุงเทพฯ เป็นที่ตั้งสำนักงานภูมิภาคแห่งใหญ่ที่สุดของ Agoda ทั่วโลก และเป็น...
 0

บีโอไอ เผยผลสำเร็จวีซ่า LTR ครบ 4 ปี ดึงชาวต่างชาติคุณภาพสูงจากทั่วโลกเข้าไทยกว่า 12,000 คน สร้างมูลค่าเพิ่มทางเศรษฐกิจกว่า 43,000 ล้านบาท...
0

สยามพิวรรธน์ ปักธง “ไอคอนภูเก็ต” สัญลักษณ์ใหม่แห่งแดนใต้ สู่จุดหมายระดับโลก เปิดให้บริการ 2572
สยามพิวรรธน์เปิดตัว “ไอคอนภูเก็ต” (ICONPHUKET) โครงการแลนด์มาร์กมูลค่าการลงทุน 10,000 ล้านบาท ภายใต้แนวคิด Hybrid Retail-Attraction & Entertainment Destination พร้อม 12 World-Class...
0