ทำไม AI ในองค์กรไทยไปได้แค่แชตบอต DataArc ชี้ปัญหาอาจอยู่ที่ข้อมูลภาษาไทย
DataArc บริษัทด้าน Synthetic Data (ข้อมูลที่สร้างขึ้นให้คงรูปแบบทางธุรกิจของข้อมูลจริงไว้ โดยตัดทุกอย่างที่ระบุตัวตนออก เพื่อใช้ฝึกและประเมินโมเดล AI) เลือกประเทศไทยเป็นหมุดหมายแรก เพื่อช่วยให้องค์กรไทยนำข้อมูลของตัวเองที่มีอยู่น้อย และอ่อนไหวมาสร้างมูลค่าได้
DataArc มองว่าสิ่งที่ทำให้ AI ในองค์กรไทยไปได้แค่ระดับแชตบอตคือ 'Thai Data Wall' หรือกำแพงข้อมูลภาษาไทย นั่นคือข้อมูลภาษาไทยที่ใช้ฝึกโมเดลได้จริงมีไม่พอ
DataArc ก่อตั้งภายใต้การบ่มเพาะของสถาบัน International Digital Economy Academy (IDEA) นำโดย Dr. Xuhui Jiang ซึ่งเป็น CEO และ Dr. Chengjin Xu ซึ่งเป็น CTO โดยมีผลงานวิจัยและตีพิมพ์มากกว่า 100 ฉบับในเวทีวิชาการด้าน AI ชั้นนำระดับโลก ซึ่งมีการนำไปใช้อ้างอิงรวมกันมากกว่า 7,000 ครั้งทั่วโลก รวมถึงผลงานวิชาการวิจัยและพัฒนาจนเป็นต้นแบบของ Context Graph (arXiv:2406.11160)
กำแพงข้อมูลภาษาไทยที่ฉุด AI ในองค์กร
ผลสำรวจ AWS ปี 2026 ระบุว่า 43% ของบริษัทไทยใช้ AI อย่างสม่ำเสมอ เพิ่มจาก 32% ในปีก่อน แต่ 74% ของบริษัทที่เริ่มใช้ AI ยังอยู่ในระดับพื้นฐาน ส่วนใหญ่คือการใช้แชตบอตสำเร็จรูปกับงานประจำ ผลสำรวจเดียวกันพบว่า 51% ของบริษัทไทยมองว่าการขาดแคลนทักษะในการปรับใช้ AI เป็นอุปสรรคใหญ่ที่สุด
ไทยตั้งเป้าเป็นศูนย์กลาง AI ของอาเซียนภายในปี 2027 ความพร้อมด้าน AI ของภาครัฐอยู่อันดับ 37 ของโลก แต่การใช้งาน AI ของไทยอยู่อันดับ 89 DataArc เห็นว่าทักษะไม่ใช่ปัจจัยเดียว อีกตัวแปรที่แทบไม่มีใครพูดถึงคือข้อมูลภาษาไทยที่ใช้งานได้จริง
ตามข้อมูลของ W3Techs ภาษาอังกฤษคิดเป็นเกือบครึ่งหนึ่งของเนื้อหาเว็บ (49.2%) ส่วนงานวิจัยโมเดลภาษาไทย Typhoon พบว่าภาษาไทยมีไม่ถึง 0.5% ของ Common Crawl และข้อมูลภาษาไทยจำนวนมากยังซ้ำหรือคุณภาพต่ำ นำมาพัฒนา AI ได้ไม่เต็มประสิทธิภาพ DataArc เรียกสิ่งนี้ว่า Thai Data Wall
ผลที่ผู้ใช้เห็นได้ในชีวิตประจำวันคือ AI ตอบไม่ตรงคำถาม อ่านชื่อคนหรือคำเฉพาะภาษาไทยผิด ตัดวรรณยุกต์ทิ้ง หรือเดาเสียงผิดจนความหมายเปลี่ยน คนไทยพูดไทยคำอังกฤษคำในประโยคเดียวกันเป็นเรื่องปกติ แต่โมเดลหลายตัวจับได้ทีละภาษา และมักแปลงวันที่แบบพุทธศักราชเป็นคริสต์ศักราชเอง งานบริการลูกค้าของธนาคาร งานเวชระเบียนของโรงพยาบาล หรืองานเอกสารภาครัฐพลาดเรื่องนี้ไม่ได้
อีกด้านคือกฎหมาย การฝึก AI ให้เข้าใจบริบทองค์กรต้องใช้ข้อมูลภายในที่สำคัญ หลายหน่วยงานจึงไม่แน่ใจว่านำข้อมูลเข้าระบบเพื่อพัฒนาโมเดลได้ถูกต้องตามกฎหมายหรือไม่ DataArc ระบุว่าอุปสรรคจาก PDPA ที่พบบ่อยมี 3 ข้อ
ข้อแรกคือหลักการจำกัดวัตถุประสงค์ ข้อมูลส่วนบุคคลที่เก็บมาเพื่อให้บริการไม่ได้เก็บมาเพื่อฝึกโมเดล การฝึกจึงถือเป็นวัตถุประสงค์ใหม่ที่ฐานทางกฎหมายเดิมไม่ได้ครอบคลุมโดยอัตโนมัติ
ข้อที่สองคือข้อมูลอ่อนไหว เช่น เวชระเบียนและข้อมูลชีวมิติ ซึ่งมีเกณฑ์เข้มกว่าอย่างมีนัยสำคัญ โรงพยาบาลและบริษัทประกันจึงติดขัดเร็วและหนักที่สุด
ข้อที่สามคือการส่งข้อมูลข้ามพรมแดน เมื่อการฝึกโมเดลต้องให้ข้อมูลออกนอกประเทศไปยังโครงสร้างพื้นฐานของผู้ให้บริการ องค์กรต้องตอบคำถามเรื่องการโอนข้อมูล และในภาคธุรกิจที่มีการกำกับดูแล คำตอบภายในมักเป็นไม่ ทั้งสามข้อเป็นเหตุผลที่เจ้าหน้าที่กำกับการปฏิบัติตามกฎเกณฑ์ปฏิเสธ และความแม่นยำของโมเดลที่สูงขึ้นไม่ช่วยแก้ข้อใดเลย
ข้อมูลโลกใกล้หมด AI เริ่มช่วยพัฒนาตัวเอง และทางออกของ DataArc
DataArc ชี้สัญญาณจากระดับโลกสองข้อ ข้อแรกคือข้อมูลสำหรับสอน AI กำลังจะหมด Ilya Sutskever ผู้ร่วมก่อตั้ง OpenAI เคยกล่าวไว้ตั้งแต่ปี 2024 ว่าข้อมูลคือ 'เชื้อเพลิงฟอสซิล' ของ AI และโลกมาถึงจุดที่ข้อมูลเหลือไม่พอให้พัฒนาต่อ ขณะที่ข้อมูลสังเคราะห์เริ่มเป็นทางออก โมเดลเปิด Nemotron-4 340B ของ NVIDIA ขนาด 340,000 ล้านพารามิเตอร์ ใช้ข้อมูลสังเคราะห์มากกว่า 98% ในขั้นตอน alignment (การปรับโมเดลให้ตอบตามที่ต้องการ) ข้อที่สองคือ AI เริ่มมีส่วนในการพัฒนาตัวเอง นักวิจัยเรียกว่า RSI (recursive self-improvement หรือการพัฒนาตัวเองแบบวนซ้ำ) ตัวอย่างที่ DataArc อ้างคือ AlphaEvolve ของ Google DeepMind ที่ใช้งานจริงมากว่าหนึ่งปี ปรับประสิทธิภาพโครงสร้างพื้นฐานการประมวลผลที่ตัวมันเองทำงานอยู่ และเอกสารเปิดตัว GPT-5.3-Codex ของ OpenAI ระบุว่าโมเดลมีบทบาทสำคัญในการสร้างตัวมันเองขึ้นมา สรุปว่าเมื่อรวมสองสัญญาณนี้ ตลาดที่มีวงจรข้อมูลหมุนต่อเนื่องจะแข็งแรงขึ้นทุกเดือน ส่วนตลาดที่ยังติดอยู่หลังกำแพงจะยิ่งถอยห่างออกไป
บริษัทมองว่าองค์กรที่อยากให้ AI แข็งแรงขึ้นต่อเนื่องต้องมีสองอย่าง คือแหล่งข้อมูลฝึกคุณภาพสูงที่ป้อนได้สม่ำเสมอ และระบบประเมินผลที่บอกได้ว่าการพัฒนาแต่ละรอบทำให้โมเดลดีขึ้น ปลอดภัยขึ้น และยังอยู่ในกรอบที่กฎหมายกำหนด DataArc บอกว่าตัวเองสร้างทั้งสองอย่าง

Dr. Xuhui Jiang ผู้ก่อตั้งและ CEO กล่าวถึงที่มาของบริษัทว่า
เราไม่ได้ตั้งใจก่อตั้งบริษัทนี้ขึ้นมาเพื่อต้องการสร้างโมเดลเพิ่มเติม เราเริ่มก่อตั้งบริษัทนี้เพราะเราเห็นว่าปัญหาที่ยากที่สุดของการพัฒนา AI ในทางปฏิบัติคือปัญหาเรื่องจำนวนข้อมูลที่ไม่เพียงพอในการเทรน AI ให้ฉลาดและมีประสิทธิภาพ องค์กรที่ต้องการใช้ AI จำนวนมาก ทั้งในภาคการเงิน สาธารณสุข และรัฐบาล โดยเฉพาะภาษาที่มีฐานข้อมูลน้อยมากในโลกอย่างภาษาไทย หลายองค์กรเจอปัญหามีข้อมูลน้อยเกินไป ข้อมูลเป็นความลับขององค์กรไม่สามารถนำมาใช้เทรน AI ได้ รวมถึงคุณภาพของข้อมูลยังไม่ดีพอ ถ้าเราแก้ปัญหาในจุดนี้ได้ การพัฒนาโมเดลให้สอดคล้องกับความต้องการขององค์กรไทยแม้จะมีจำนวนข้อมูลที่จำกัด จึงสามารถเป็นไปได้อย่างดีเยี่ยม
เครื่องมือสร้าง Synthetic Data ของ DataArc เน้นสองสถานการณ์ที่ข้อมูลจริงหายากที่สุด

สถานการณ์แรกคือ Language alignment หรือการปรับโมเดลให้เข้ากับภาษา ภาษาที่มีทรัพยากรน้อยอย่างภาษาไทยมีคลังข้อมูลสาธารณะอยู่บางตา และข้อมูลเสียงมีต้นทุนสูงทั้งตอนเก็บและตอนกำกับป้ายข้อมูล DataArc ใช้ข้อมูลสังเคราะห์หลายรูปแบบฝึกและปรับโมเดลรู้จำเสียงพูดภาษาไทย (ASR) และโมเดลสังเคราะห์เสียงพูด (TTS) โดยจับโครงสร้างวรรณยุกต์ พฤติกรรมการสลับภาษา และการเปลี่ยนระดับภาษาที่โมเดลทั่วไปมองข้าม ตามข้อมูลการทดสอบภายในของ DataArc ซึ่งเทียบกับโมเดลระดับโลก ระบบ ASR ภาษาไทยทำความแม่นยำได้ 92.79%
สถานการณ์ที่สองคือ Industry alignment หรือการปรับโมเดลให้เข้ากับอุตสาหกรรม ซึ่งแก้ปัญหาที่ AI agent ไม่รู้ว่าธุรกิจทำงานอย่างไร เพราะเอกสารองค์กรไม่เท่ากับประสบการณ์ขององค์กร และวิจารณญาณของผู้พิจารณารับประกันอาวุโสหรือเจ้าหน้าที่กำกับการปฏิบัติตามกฎเกณฑ์แทบไม่ปรากฏในไฟล์ที่ AI อ่านได้ เทคโนโลยี Context Graph ของ DataArc จัดโครงสร้างตรรกะการตัดสินใจเหล่านี้ แล้วขยายเป็นเส้นทางการฝึกด้วยวิธีสังเคราะห์ DataArc ระบุว่าใช้แนวทางนี้กับสถาบันการเงินชั้นนำในฮ่องกง ซึ่งบริษัทขอสงวนสิทธิ์ไม่เปิดเผยชื่อ และประสิทธิภาพโมเดลสูงขึ้นพร้อมต้นทุนการนำไปใช้ลดลง
ทั้งสองแนวทางส่งมอบผ่าน API สำหรับองค์กร หรือติดตั้งภายในระบบขององค์กรเอง DataArc ตอบข้อสงสัยว่าโมเดลระดับแนวหน้าจะเก่งภาษาไทยขึ้นเองหรือไม่ว่าเป็นไปได้ แต่มีสามอย่างที่จะไม่มาพร้อมกัน คือวิธีทำธุรกิจจริงของอุตสาหกรรมไม่ได้อยู่บนอินเทอร์เน็ตสาธารณะ ข้อมูลแกนกลางวางบนเซิร์ฟเวอร์ของคนอื่นไม่ได้ และเมื่อหน่วยงานกำกับดูแลถาม ความรับผิดชอบยังเป็นขององค์กรเองอยู่ดี
ในส่วน PDPA บริษัทระบุว่าการฝึกโมเดลไม่จำเป็นต้องใช้ข้อมูลต้นฉบับ ข้อมูลองค์กรยังอยู่ภายในองค์กร สิ่งที่ใช้ฝึกคือข้อมูลสังเคราะห์ที่ต่อยอดจากงานวิจัยที่ได้รับการตอบรับใน Findings of EACL 2026 ข้อมูลลับที่ใช้ฝึกไม่ได้จะถูกเข้ารหัสตั้งแต่ขั้นสร้าง เกิดเป็นสิ่งที่ทีมเรียกว่า 'semantic break' หรือรอยแยกเชิงความหมาย ซึ่งลดความเสี่ยงที่ข้อมูลจะถูกประกอบกลับคืน จากข้อมูลจริงชุดเดียว เครื่องมือสร้างชุดข้อมูลสำหรับฝึกและประเมินผลได้มากกว่าต้นฉบับ 10 ถึง 30 เท่า ตามการวัดผลทางวิศวกรรมของ DataArc และช่วยลดภาระที่ฝ่ายกฎหมายต้องเช็กเอกสารและเซ็นอนุมัติการใช้ข้อมูลส่วนตัวขององค์กร
เมื่อเทียบกับอุปสรรคสามข้อข้างต้น DataArc อธิบายว่าข้อมูลต้นฉบับไม่เคลื่อนย้าย คำถามเรื่องการส่งข้อมูลข้ามพรมแดนจึงไม่เกิดขึ้น สิ่งที่ใช้ฝึกเป็นข้อมูลที่สร้างขึ้นแทนข้อมูลที่เก็บมา ซึ่งแยกวัตถุประสงค์ของการฝึกออกจากวัตถุประสงค์เดิมที่เก็บข้อมูล และกรณีที่เกิดไม่บ่อยสังเคราะห์ขึ้นได้โดยไม่ต้องเก็บเพิ่ม ปริมาณข้อมูลอ่อนไหวจริงที่ถูกแตะต้องจึงลดลงเมื่อโมเดลพัฒนาไป คำถามของเจ้าหน้าที่กำกับการปฏิบัติตามกฎเกณฑ์จึงเปลี่ยนจากการอนุมัติข้อยกเว้นหรือไม่ เป็นกระบวนการสร้างข้อมูลรัดกุมพอหรือไม่
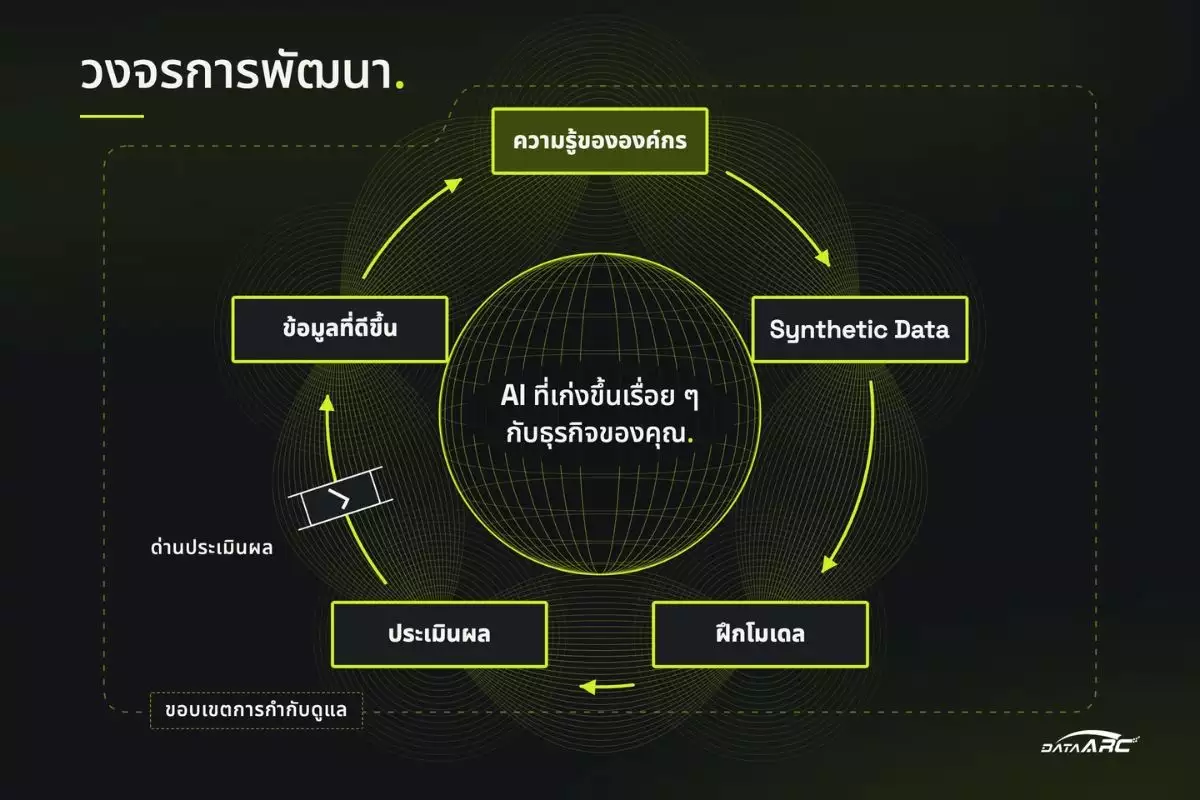
สิ่งที่ DataArc ส่งมอบเป็นวงจรการทำงาน คือถอดความรู้ขององค์กร สังเคราะห์ข้อมูลฝึกจากความรู้นั้น ฝึกและประเมินผล สร้างข้อมูลที่ดีขึ้น แล้ววนซ้ำ โดยทุกรอบต้องผ่านด่านประเมินผลที่สร้างบนงานวิจัยด้านการประเมินโมเดลภาษาขนาดใหญ่ ซึ่งบริษัทระบุว่าทีมงานได้รับรางวัล และทำงานภายในขอบเขตการกำกับดูแลที่กำหนดไว้ชัดเจน วัดผลและตรวจสอบย้อนหลังได้ Dr. Xuhui Jiang กล่าวว่าทีมเรียกแนวคิดนี้ว่าการพัฒนาตัวเองที่ยึดโยงกับธุรกิจ (Business-Grounded RSI) และมีเพียงระบบที่มีตัวประเมินผลเข้มงวดอยู่ภายในเท่านั้นที่สมควรได้สิทธิ์พัฒนาตัวเองต่อ โดยทุกย่างก้าวของการเติบโตตรวจสอบได้
DataArc เห็นว่าโมเดลทุกตัวที่ฝึกด้วยข้อมูลภาษาไทยและเกณฑ์วัดผลทั้งหมดถูกสร้างขึ้นในประเทศไทย จะช่วยเพิ่มขีดความสามารถด้าน AI ของตลาดไทยเอง และลดการพึ่งพาโมเดลภาษาจากต่างประเทศในระยะยาว
งานที่ทำแล้วในไทย และกลุ่มที่จะขยายต่อ
DataArc ระบุว่าใช้เวลาไม่ถึงหนึ่งปีในการขยับจากการวิจัยและพัฒนาเทคโนโลยีมาสร้างระบบ AI ที่ใช้งานจริงร่วมกับพันธมิตรไทย
งานแรกคือระบบสรุปการประชุมอัจฉริยะ ที่นำร่องกับมหาวิทยาลัยเทคโนโลยีราชมงคลพระนคร (RMUTP) ระบบแปลงเสียงภาษาไทยเป็นข้อความอัตโนมัติ แล้วให้ AI สรุปการประชุมและทำรายงานการประชุมได้ทันที ความท้าทายคือภาษาไทยมีหลายระดับ ทั้งราชาศัพท์ ศัพท์การแพทย์ และศัพท์กฎหมาย รายงานการประชุมของหน่วยงานราชการที่ภาษาไม่ผ่านมาตรฐานภาษาราชการจะถูกตีกลับ AI จึงต้องเขียนอย่างเป็นทางการ เข้าใจบริบทองค์กรไทย และรู้ว่าผู้ใช้จะนำรายงานไปใช้ในบริบทใด
งานที่สองคือ AI พากย์เสียงสำหรับงานแปลสื่อ ร่วมกับบริษัทสื่อและคอนเทนต์รายใหญ่ของไทย ซึ่ง DataArc ขอสงวนสิทธิ์ไม่เปิดเผยชื่อ ตามข้อมูลการใช้งานจริงของ DataArc กระบวนการพากย์เสียงแบบครบวงจรย่นเวลาทำงานสำหรับคอนเทนต์นำเข้าจากราว 4 ชั่วโมงเหลือประมาณ 20 นาทีต่อหนึ่งตอน โดยยังรักษาโทนและอารมณ์ของการแสดงต้นฉบับไว้ บริษัทมองว่าผู้ชมไทยย้ายมาสู่ซีรีส์สั้นและคอนเทนต์ต่างประเทศอย่างรวดเร็ว และคอขวดของการนำคอนเทนต์เข้าไทยเปลี่ยนจากต้นทุนลิขสิทธิ์มาเป็นกำลังการผลิตงานแปลและพากย์
ส่วนงานที่ยังอยู่ในขั้นเสนอและวางแผนมีสามกลุ่ม กลุ่มแรกคือคอลเซ็นเตอร์ ซึ่ง DataArc กำลังนำเสนอต่อหน่วยงานในไทย โดยระบุว่าคอลเซ็นเตอร์ไทยทั่วไปสุ่มตรวจสายเพียงสัดส่วนเล็กน้อย เพราะการฟังย้อนหลังต้องใช้คนและเวลา สิ่งที่ลูกค้าพูดจริงส่วนใหญ่จึงไม่เคยถูกนำมาวิเคราะห์ ขณะที่สำเนียงถิ่น จังหวะการพูด การเปลี่ยนระดับคำสุภาพ และชื่อสินค้าภาษาอังกฤษที่แทรกในประโยคไทย ยังเป็นจุดอ่อนของโมเดลเสียงทั่วไป หากทำได้ การประกันคุณภาพจะเปลี่ยนจากสุ่มตรวจเป็นตรวจครบทุกสาย และคลังบทสนทนาจะกลายเป็นข้อมูลที่ธุรกิจค้นหาได้ กลุ่มที่สองและสามคือค้าปลีกกับอุตสาหกรรมการผลิต ซึ่ง DataArc คาดว่าจะขยายไปเป็นลำดับถัดไป ทั้งสองกลุ่มมีข้อมูลอยู่แล้วแต่ไม่อยู่ในรูปแบบที่โมเดลทั่วไปเรียนรู้ได้
และอีกโครงการหนึ่งที่อยู่ระหว่างการหารือคือการใช้ AI เพื่อการเข้าถึงบริการของประชาชน โดย DataArc ได้เข้าร่วมหารือกับ United Nations Population Fund (UNFPA) ประจำประเทศไทย และทีม Fongdee/TraffyFondue ผู้พัฒนาแพลตฟอร์ม SoSafe ถึงความเป็นไปได้ในการนำ Voice AI ภาษาไทยมาช่วยให้ผู้สูงอายุ ผู้พิการ และผู้ที่ไม่ถนัดการพิมพ์ สื่อสารกับแพลตฟอร์มด้วยเสียงพูดแทนการพิมพ์ รวมถึงช่วยให้ประชาชนค้นหาข้อมูลด้านสุขภาพ สิทธิ และบริการภาครัฐที่เชื่อถือได้ง่ายขึ้น ภายใต้การออกแบบที่คำนึงถึงความเป็นส่วนตัวและความปลอดภัยของผู้ใช้งาน
นอกจากนี้ DataArc จัดกิจกรรม AI tech talk เพื่อเริ่มสร้าง AI Ecosystem ในสถาบันการศึกษาชั้นนำของไทย รวมถึงจุฬาลงกรณ์มหาวิทยาลัย โดยทำร่วมกับ Huawei Cloud และรับนักศึกษาไทยเข้าฝึกงาน เพื่อให้ได้เรียนรู้เรื่อง AI และเข้าร่วมทีมวิจัยและพัฒนาระบบ AI โดยตรง

คุณนนทนีย์ เฉิน (นนนี่) ผู้จัดการฝ่ายพัฒนาธุรกิจ ประเทศไทย ของ DataArc กล่าวว่า
เทรนด์ในปีนี้ หลาย ๆ องค์กรในไทยไม่ได้ตั้งคำถามแล้วว่า AI แบบไหนคือฉลาดที่สุด แต่หลาย ๆ องค์กรกำลังพุ่งเป้าไปที่ทำอย่างไรให้ AI สามารถใช้งานได้จริงอย่างมีประสิทธิภาพ ช่วยเพิ่มผลลัพธ์ในองค์กร ดังนั้นการสร้าง AI โมเดลที่เข้าใจบริบทในภาคธุรกิจไทย และนำไปใช้งานได้จริง คือโจทย์ที่ท้าทายและเราต้องทำให้สำเร็จเท่านั้น เพื่อผลลัพธ์ที่ดีของผู้ใช้งาน และเพื่อสร้างความยั่งยืนให้ภาคธุรกิจโดยรวม
DataArc เสนอให้องค์กรไทยเริ่มจากก้าวเล็ก ๆ คือเลือกกระบวนการเดียวที่ภาษาไทยเป็นคอขวดและมีปริมาณงานจริง เช่น สายบริการลูกค้า การจัดทำเอกสาร หรือการตรวจคุณภาพที่ต้องสุ่มเพราะตรวจครบไม่ไหว ประเมินว่าความแม่นยำในกระบวนการนั้นมีมูลค่าเท่าไรเป็นชั่วโมงหรือเงินบาท แล้วทดสอบว่าระบบที่ฝึกด้วยข้อมูลของตัวเองทำได้ดีกว่าเครื่องมือทั่วไปที่ใช้อยู่หรือไม่ บริษัทบอกว่าคำถามนี้ตอบได้ภายในไม่กี่สัปดาห์ DataArc กำลังเปิดรับความร่วมมือโครงการนำร่องรอบถัดไปกับองค์กรไทยในกลุ่มสื่อ งานบริการลูกค้า และภาครัฐ ติดต่อทีมประเทศไทยได้ที่ [email protected] หรือดูข้อมูลเพิ่มเติมที่ dataarc.tech
DataArc มองว่า Thai Data Wall วัดว่าองค์กรลงมือทำให้ความรู้ของตัวเองใช้งานได้จริงแล้วหรือยัง องค์กรที่ข้ามกำแพงนี้ได้ก่อนจึงเป็นองค์กรที่เข้าใจก่อนใครว่าโมเดลไม่เคยเป็นของที่ขาดแคลน
แหล่งที่มา
- บทความและตารางแหล่งอ้างอิงจาก DataArc dataarc.tech
- AWS, Unlocking Thailand's AI Potential 2026 ผ่าน Nation Thailand และ Asia News Network
- Oxford Insights, Government AI Readiness Index 2025
- W3Techs, Content Languages Statistics
- Typhoon, Thai Large Language Models (arXiv:2312.13951)
- NVIDIA Nemotron-4 340B Technical Report (arXiv:2406.11704)
- Context Graph (arXiv:2406.11160)
- Xu et al., Continual Pretraining on Encrypted Synthetic Data for Privacy-Preserving LLMs, Findings of EACL 2026
- Ilya Sutskever, การบรรยาย NeurIPS 2024 ตามที่อ้างใน The Verge
- Google Cloud Blog เรื่อง AlphaEvolve และเอกสารเปิดตัว GPT-5.3-Codex ของ OpenAI ตามตารางอ้างอิงของ DataArc
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด

จุฬาฯ เปิด Chula Silicon Square ชูแนวคิด Startup for All
จุฬาฯ เปิดพื้นที่นวัตกรรมแห่งใหม่ Chula Silicon Square ที่ชั้น 11 อาคารจามจุรีสแควร์ ภายใต้นโยบาย Startup for All...
 0

คุณธนิศร์ เจียรวนนท์ ประธานคณะผู้บริหาร กลุ่มธุรกิจค้าส่ง ซีพี แอ็กซ์ตร้า เข้าร่วมเสวนาในงาน ASEAN Inclusive Growth Summit ที่กรุงมะนิลา แบ่งปันมุมมองเรื่องเทคโนโลยี การเปลี่ยนผ่าน...
0

PTG เปิดตัวแคมเปญ “PTG Carbon Balance Journey” ขับเคลื่อน 4 ภารกิจคืนสมดุลคาร์บอน มุ่งสู่ Carbon Neutrality 2030 พร้อมชวนสมาชิก Max Card ร่วมลดคาร์บอน...
0