AlphaFold เพิ่มข้อมูลโครงสร้าง โปรตีนไวรัสกว่า 8,000 คู่ ครอบคลุมไวรัส 2,800 ชนิด 23 ตระกูล เพื่อเตรียมรับมือโรคระบาดใหญ่ครั้งหน้า
AlphaFold Database คลังโครงสร้างโปรตีนที่ AI ทำนายไว้ครอบคลุมแทบทุกโปรตีนที่วงการวิทยาศาสตร์รู้จัก เพิ่งเติมข้อมูลชุดใหญ่ที่เจาะจงไปที่ไวรัสโดยเฉพาะ พร้อมเปิดพื้นที่ใหม่ชื่อ Pandemic Preparedness Portal ที่รวมโครงสร้างไวรัสทั้งหมดในฐานข้อมูลไว้ในหน้าเดียว ครอบคลุมไวรัสราว 2,800 ชนิดจาก 23 ตระกูลที่มีสมาชิกก่อโรคในคน ตั้งแต่ไวรัสไข้หวัดธรรมดา หัด ตับอักเสบบี ไปจนถึงเอ็มพอกซ์ (Mpox)
จุดที่ต่างจากข้อมูลเดิมคือครั้งนี้ไม่ได้ดูโปรตีนทีละตัว แต่ดูโปรตีนที่ทำงานจับคู่กัน หรือที่เรียกว่าไดเมอร์ (Dimer) แบ่งเป็นโฮโมไดเมอร์ (Homodimer) คือโปรตีนชนิดเดียวกันสองสายจับกัน และเฮเทอโรไดเมอร์ (Heterodimer) คือโปรตีนต่างชนิดจับคู่กัน Joe Grove ศาสตราจารย์ด้านไวรัสวิทยาระดับโมเลกุล มหาวิทยาลัยกลาสโกว์ (University of Glasgow) หนึ่งในทีมที่ร่วมเพิ่มข้อมูลชุดนี้ อธิบายว่าโปรตีนไวรัสจำนวนมากไม่ได้ทำงานเดี่ยว ๆ แต่ทำงานประสานกับคู่ของมัน การรู้แค่รูปทรงของโปรตีนเดี่ยวจึงยังไม่พอ
เหตุผลที่ต้องรู้รูปทรง 3 มิติของโปรตีนเหล่านี้ เพราะมันบอกได้ว่าบริเวณไหนบนผิวไวรัสคือเป้าหมายที่ใช้พัฒนาชุดตรวจ ยา และวัคซีนได้ ซึ่งเป็นข้อมูลที่ตามปกติต้องใช้ห้องปฏิบัติการเฉพาะทาง ใช้เวลานาน และมีต้นทุนสูง
บทเรียนโควิด-19 กับเป้าหมายมีวัคซีนใน 100 วัน
การปล่อยข้อมูลชุดนี้ไม่ได้เป็นแค่การอัปเดตฐานข้อมูล แต่จับจังหวะให้ตรงกับการประชุมระดับสูงของสมัชชาใหญ่สหประชาชาติว่าด้วยการป้องกันและรับมือโรคระบาดใหญ่ที่นิวยอร์ก โดยประกาศครั้งแรกในวงโต๊ะกลมที่ Coalition for Epidemic Preparedness Innovations (CEPI) จัดร่วมกับ World Economic Forum (WEF)
เหตุผลอยู่ที่ตัวเลขประเมินความเสี่ยง ศูนย์วิจัย Center for Global Development ประเมินว่าโลกมีโอกาสเกือบ 50% ที่จะเจอโรคระบาดใหญ่รุนแรงระดับโควิด-19 อีกครั้งภายในปี 2050 ขณะที่โครงการ 100 Days Mission ตั้งเป้าให้มีวัคซีนและยาที่ปลอดภัยพร้อมใช้ภายใน 100 วันหลังพบภัยคุกคามใหม่
เป้าหมายระดับนั้นเป็นไปได้ก็ต่อเมื่อมีข้อมูลโครงสร้างของไวรัสเตรียมไว้ล่วงหน้า ก่อนที่ไวรัสตัวใดจะกลายเป็นปัญหาระดับโลก การเลือกว่าจะทำนายไวรัสตระกูลไหนจึงอ้างอิงเครื่องมือจัดลำดับความสำคัญเชื้อก่อโรคของหน่วยงานความมั่นคงด้านสุขภาพแห่งสหราชอาณาจักร (UK Health Security Agency) และเน้นตระกูลที่เคยมีสมาชิกก่อโรคในคนมาแล้ว เพราะไวรัสอุบัติใหม่ส่วนใหญ่มักโผล่มาจากตระกูลเดิมที่รู้จักกันอยู่แล้ว
Jo McEntyre รักษาการผู้อำนวยการ European Molecular Biology Laboratory's European Bioinformatics Institute (EMBL-EBI) ระบุว่าการเปิดข้อมูลชุดนี้ยังช่วยลดกำแพงให้นักวิทยาศาสตร์ในประเทศที่ทรัพยากรจำกัด ซึ่งมักเป็นกลุ่มที่ต้องเผชิญการระบาดก่อนใคร
เบื้องหลังคือความร่วมมือข้ามทวีปที่มี NVIDIA ช่วยเรื่องพลังประมวลผล
AlphaFold Database เกิดจากความร่วมมือระหว่าง Google DeepMind กับ EMBL-EBI เมื่อกว่า 5 ปีก่อน ปัจจุบันมีโครงสร้างที่ทำนายไว้แล้วมากกว่า 260 ล้านรายการ และมีผู้ใช้กว่า 3 ล้านคน
ข้อมูลไวรัสรอบนี้ดึงหลายองค์กรเข้ามาร่วม ทั้ง EMBL-EBI, Google DeepMind, NVIDIA, มหาวิทยาลัยแห่งชาติโซล (Seoul National University), มหาวิทยาลัยกลาสโกว์, Swiss Institute of Bioinformatics (SIB), CEPI และมหาวิทยาลัยซองกยุนกวาน (Sungkyunkwan University) ของเกาหลีใต้ โดยฝั่ง NVIDIA เข้ามาช่วยปรับแต่งกระบวนการทำนายขนาดใหญ่ผ่าน NVIDIA BioNeMo Inference Runtime นอกจากนี้ยังมีโฮโมไดเมอร์ของไวรัสอีก 4,681 คู่จากห้องปฏิบัติการ Atkinson มหาวิทยาลัยลุนด์ (Lund University) สวีเดน ที่คำนวณแยกกันมาและถูกนำมารวมไว้ด้วย
Anthony Costa ผู้อำนวยการฝ่าย Digital Biology ของ NVIDIA ระบุว่าการเตรียมพร้อมรับมือโรคระบาดขึ้นอยู่กับการมีข้อมูลระดับโมเลกุลคุณภาพสูงอยู่ในมือตั้งแต่ก่อนการระบาดจะเริ่ม ด้าน Anna Koivuniemi หัวหน้า Google DeepMind Impact Accelerator ระบุว่าการนำโมเดล 3 มิติเหล่านี้เข้าฐานข้อมูลทำให้มันพร้อมใช้งานจริงทันที โดยเฉพาะกับนักวิจัยในพื้นที่ที่กำลังเจอการระบาดเฉียบพลัน
ก่อนหน้านี้ AlphaFold Database เพิ่งเริ่มบรรจุโปรตีนเชิงซ้อน (Protein Complex) เป็นครั้งแรก ด้วยโฮโมไดเมอร์ราว 1.7 ล้านคู่จากสิ่งมีชีวิต 20 ชนิดที่นักวิทยาศาสตร์ศึกษากันแพร่หลาย เช่น มนุษย์ หนู และแบคทีเรียก่อวัณโรค ข้อมูลไวรัสชุดนี้จึงเป็นการต่อยอดไปยังกลุ่มที่ยังมีข้อมูลน้อยที่สุดกลุ่มหนึ่ง
ทำไมไวรัสถึงเป็นจุดบอดของ AlphaFold มาตลอด
แม้ฐานข้อมูลจะครอบคลุมโปรตีนเกือบทั้งหมดที่รู้จัก แต่ Joe ชี้ว่าไวรัสยังเป็นจุดบอด โปรตีนเดี่ยวหลายตัวยังไม่มีโครงสร้างคุณภาพสูง โดยเฉพาะในไวรัสกลุ่มฟลาวิไวรัส (Flavivirus) ซึ่งรวมไวรัสซิกาและไวรัสเดงกีที่เป็นต้นเหตุไข้เลือดออก
ต้นตอของปัญหาอยู่ที่วิธีเพิ่มจำนวนของไวรัสบางชนิด ที่จะแปลรหัสพันธุกรรมออกมาเป็นโปรตีนสายยาวก้อนเดียวเรียกว่าโพลีโปรตีน (Polyprotein) ก่อน แล้วค่อยถูกตัดแบ่งเป็นโปรตีนย่อยที่ทำงานได้จริง การดูจากลำดับพันธุกรรมอย่างเดียวจึงบอกไม่ได้ชัดว่าโปรตีนแต่ละตัวเริ่มและจบตรงไหน ผลคือโครงสร้างที่ทำนายออกมามักไม่สมบูรณ์
ทีม ViralZone ของ SIB ที่เจนีวาจึงเข้ามาระบุลำดับที่ถูกต้องของโปรตีนย่อยหลายพันตัวที่แยกออกจากโพลีโปรตีน ทำให้ AI ได้ทำนายโครงสร้างจากโปรตีนในรูปที่ใช้งานจริง ซึ่งเป็นกลุ่มที่แทบไม่มีข้อมูลอยู่ในฐานข้อมูลมาก่อน Philippe Le Mercier ผู้จัดการทรัพยากรของ SIB ระบุว่างานชิ้นนี้แสดงให้เห็นว่าการผสม AI ที่ทรงพลังเข้ากับข้อมูลที่ผ่านการดูแลโดยผู้เชี่ยวชาญช่วยรับมือภัยสุขภาพระดับโลกได้อย่างไร โดยเฉพาะกับไวรัสหลายชนิดที่ศึกษาได้ด้วยเครื่องมือคำนวณเท่านั้น
ทำนาย 1.7 ล้านคู่ แต่ผ่านเกณฑ์ไม่ถึง 1%
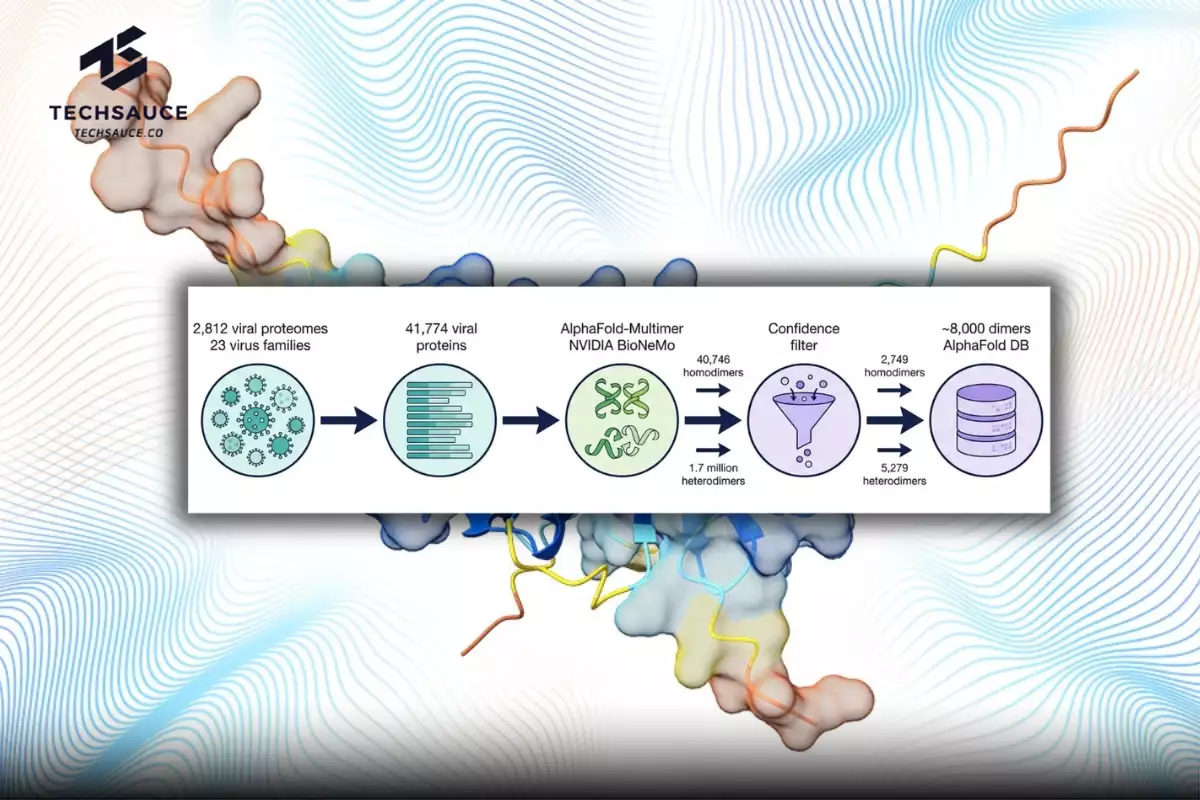
ทีมวิจัยวิเคราะห์ลำดับโปรตีน 41,774 ตัวจากไวรัส 2,812 ชนิด แล้วใช้ AlphaFold2 และ AlphaFold-Multimer ซึ่งเป็นเวอร์ชันที่ออกแบบมาทำนายโปรตีนที่จับกันเป็นชุด จับคู่โปรตีนทุกตัวภายในไวรัสแต่ละชนิดแบบครบทุกคู่ ได้การทำนายโฮโมไดเมอร์ 40,746 คู่ และเฮเทอโรไดเมอร์เกือบ 1.7 ล้านคู่
จากทั้งหมดนั้น มีเพียงโฮโมไดเมอร์ 2,749 คู่ และเฮเทอโรไดเมอร์ 5,279 คู่ รวม 8,028 คู่ หรือราว 0.47% ที่แม่นยำพอจะขึ้นหน้าฐานข้อมูล ส่วนที่เหลือยังเปิดให้ดาวน์โหลดทั้งชุดสำหรับนักวิจัยที่ต้องการนำไปวิเคราะห์ต่อ
ตัวเลขที่ต่ำนี้เป็นผลจากเกณฑ์คัดกรองที่เข้มงวดโดยตั้งใจ เมื่อทีมทดสอบเกณฑ์กับโครงสร้างไวรัสที่ได้จากการทดลองจริง 215 คู่ และคู่โปรตีนที่ไม่ได้จับกันจริงอีก 221 คู่ พบว่าเกณฑ์นี้ไม่ปล่อยคู่ที่ผิดผ่านเข้ามาเลยแม้แต่คู่เดียว แลกกับการเก็บคู่ที่ถูกต้องได้เพียงราว 14% หมายความว่าสิ่งที่ขึ้นหน้าฐานข้อมูลเน้นความน่าเชื่อถือมากกว่าปริมาณ
ข้อจำกัดที่ทีมวิจัยพูดเอง ก่อนจะมีใครถาม
ประเด็นที่ทีมวิจัยหยิบขึ้นมาพูดเองตั้งแต่วันประกาศคือขอบเขตที่ข้อมูลชุดนี้ทำไม่ได้ โครงสร้างที่ทำนายไว้บอกได้แค่ว่าโปรตีนไวรัสน่าจะมีหน้าตาอย่างไรและอาจจับกันแบบไหน แต่บอกไม่ได้ว่าการเปลี่ยนแปลงทางพันธุกรรมจะส่งผลต่อไวรัสอย่างไร และบอกไม่ได้ว่าไวรัสมีพฤติกรรมจริงอย่างไรเมื่ออยู่ในร่างกาย ซึ่งยังต้องพิสูจน์ด้วยการทดลองในห้องปฏิบัติการอยู่ดี
Joe อธิบายว่า 'โครงสร้างของโปรตีนเชิงซ้อนเพียงอย่างเดียวบอกเราไม่ได้ว่าจะเกิดอะไรขึ้นเมื่อไวรัสกลายพันธุ์' พร้อมระบุว่าชุดข้อมูลนี้ให้ความรู้พื้นฐานที่มีค่าต่อการวิจัยและการพัฒนามาตรการรับมือ แต่ไม่ได้อธิบายว่าทำไมไวรัสบางตัวถึงอยู่รอดขณะที่บางตัวไม่รอด และไม่ได้ทำให้การดัดแปลงเชื้อให้อันตรายขึ้นทำได้ง่ายขึ้น
ข้อจำกัดทางเทคนิคยังมีอีกชั้น การทำนายชุดนี้ไม่มีโมเลกุลน้ำตาลที่เกาะอยู่บนผิวโปรตีนไวรัสหลายชนิดและช่วยให้ไวรัสหลบการตรวจจับของภูมิคุ้มกัน อีกทั้งโปรตีนไวรัสจำนวนมากทำงานเป็นชุดที่ใหญ่กว่าสองสาย เช่น โปรตีนหนามของ SARS-CoV-2 ที่ประกอบจากโปรตีนเหมือนกันสามสาย กรณีแบบนี้การทำนายแบบจับคู่สองสายมักไม่แม่นพอจะผ่านเกณฑ์เข้าฐานข้อมูล
ข้อมูลทั้งหมดเปิดให้เข้าถึงฟรีแล้วผ่าน Pandemic Preparedness Portal บนหน้าแรกของ AlphaFold Database ภายใต้สัญญาอนุญาต CC-BY-4.0 ที่ใช้ได้ทั้งงานวิชาการและเชิงพาณิชย์ นอกจากพอร์ทัลไวรัสแล้ว การอัปเดตรอบนี้ยังเพิ่มพื้นที่จัดหมวดสำหรับเชื้อดื้อยาต้านจุลชีพ (Antimicrobial Resistance) โรคเขตร้อนที่ถูกละเลย (Neglected Tropical Diseases) และกลุ่มเชื้อก่อโรคสำคัญตามรายการขององค์การอนามัยโลกด้วย
ที่มา: Nature, EMBL, AlphaFold Protein Structure Database, Phys.org
ลงทะเบียนเข้าสู่ระบบ เพื่ออ่านบทความฟรีไม่จำกัด
เจาะลึก Spear-H เร่งอนาคต HealthTech ไทย
ทำความรู้จัก 12 HealthTech สตาร์ทอัพมาแรงจากโครงการ SPEAR H (โดย NIA x มหาวิทยาลัยมหิดล) ที่พร้อมเข้ามาแก้ Pain Point วงการแพทย์และยกระดับคุณภาพชีวิตคนไทยให้ดีขึ้น...
 0

Anthropic เผย Claude AI ค้นพบระบบเอนไซม์ชนิดใหม่ ART ที่ตัด-คัดลอก-วาง DNA ได้ในตัวเดียว คล้าย CRISPR โดยใช้เวลาวิเคราะห์เพียง 21 ชั่วโมง ย่นเวลาวิจัยและจุดประกายความหวังใหม่ในการร...
0

นักวิจัยจาก UC San Diego สร้าง ‘เซลล์เสมือนจริง 4 มิติ’ ช่วยนักวิทย์ฯ คาดเดาปฏิกิริยาของยาได้ดีขึ้น
UC San Diego ฝึกโมเดล AI ชื่อ MitoSpace ด้วยคลิปเซลล์ 4 มิติ 40,000 คลิป จัดกลุ่มยาตามกลไกได้แม่น 75% เทียบภาพนิ่ง 2 มิติ 56% พร้อมสร้างฝาแฝดดิจิทัลของเซลล์มะเร็งที่ทำนายฤทธิ์ยาได้...
0